Событие может начаться с короткого поста в канале. Потом о нём напишет местный сайт, в комментариях появятся подробности, а к вечеру тему подхватят крупные издания. Журналисту важно заметить её вовремя. Бизнесу, который оказался внутри обсуждения, понять, что происходит. Команде, работающей с ИИ, собрать материал для исследования или будущего датасета.
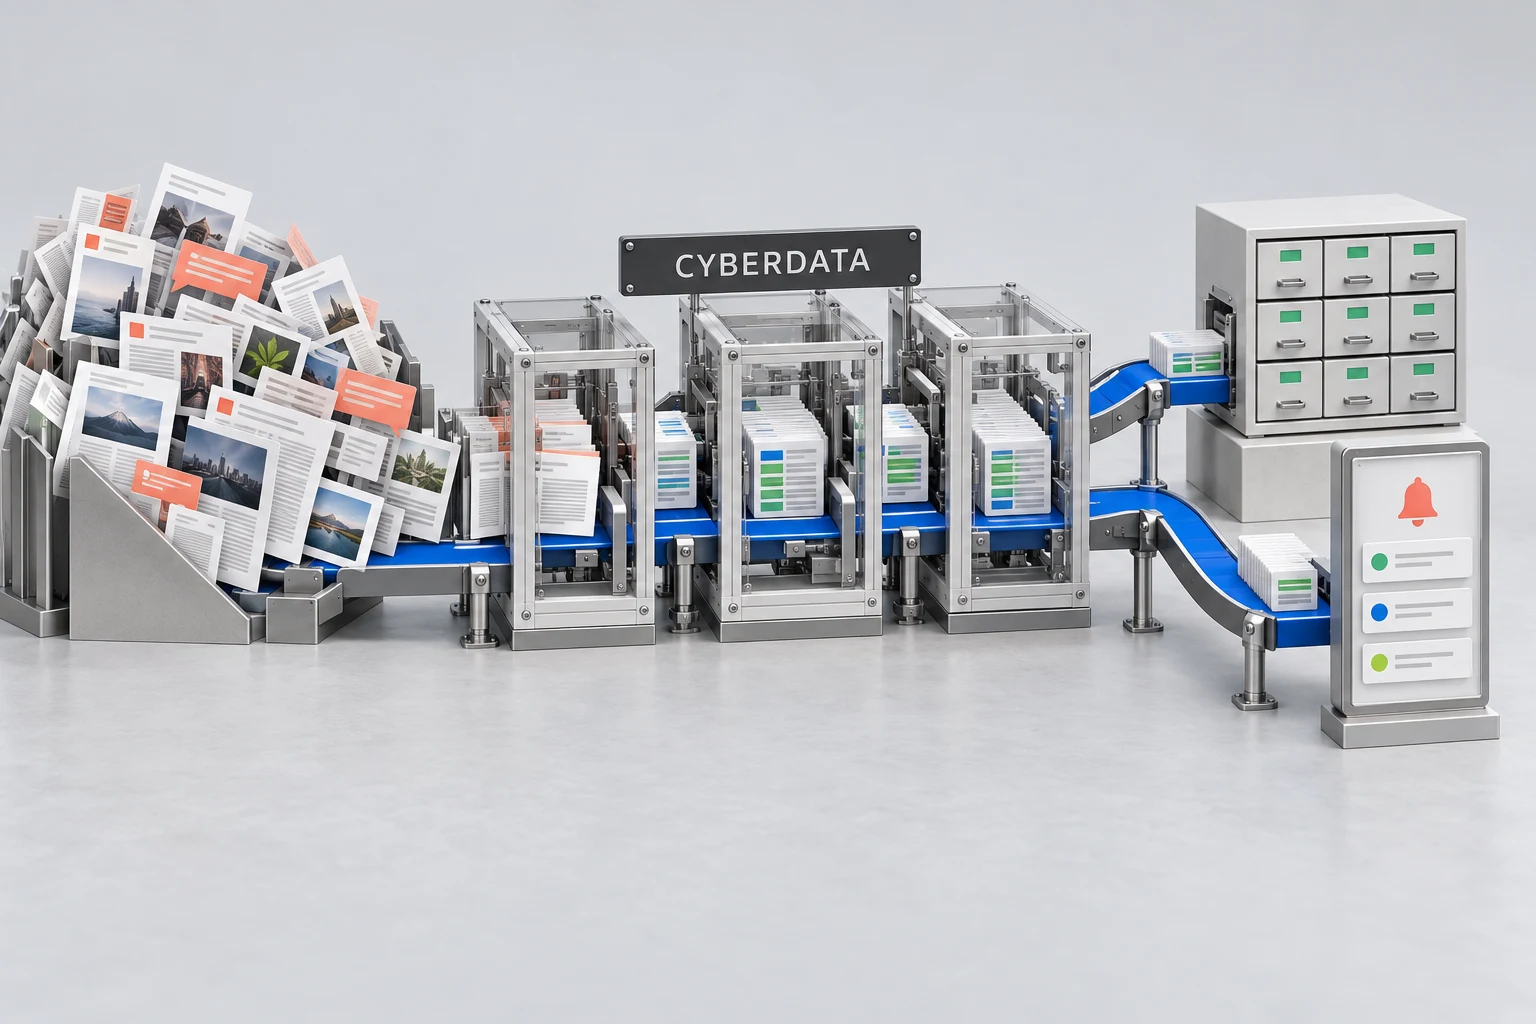
Мы создали CyberData, чтобы собирать такую информацию автоматически и превращать её в структурированные данные. Система работает с сайтами, социальными сетями, каналами и группами мессенджеров. Собранные материалы разбираются в нужный формат и дальше используются для мониторинга, аналитики или подготовки датасетов для ИИ.
По данным нашей команды разработки, объём сбора достигает сотен миллионов страниц в день. Вручную такой поток не разобрать. Поэтому загрузкой страниц работа CyberData не заканчивается: система извлекает информацию и приводит её к виду, с которым можно работать дальше.
За страницей нужно увидеть данные
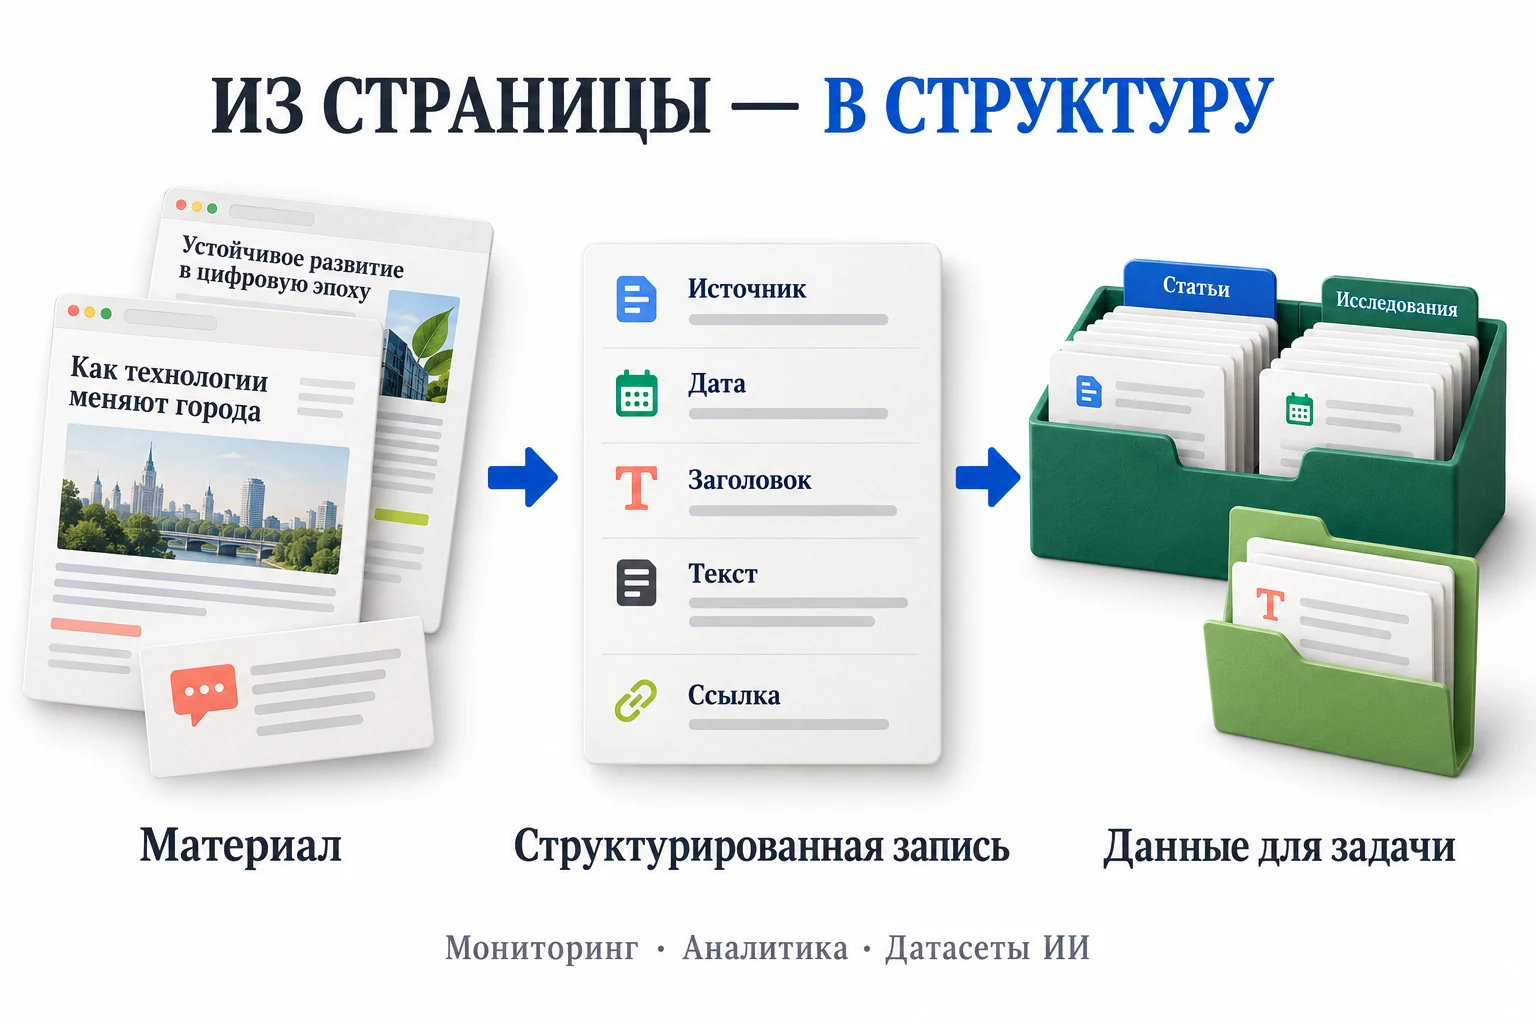
Сайт, пост в социальной сети и сообщение в канале устроены по-разному. Даже у двух новостных сайтов похожая статья может быть собрана совершенно иначе. Сохранить страницы как есть несложно. Сложнее получить из них данные, которые не придётся заново разбирать при каждом использовании.
CyberData автоматизирует и сбор, и разбор. Система приводит найденную информацию к структурам, заданным для дальнейшего использования. Для мониторинга может быть важна публикация с её источником и временем появления. Для анализа обсуждения понадобятся сообщения и контекст. Для датасета требуется корпус, который можно передать на следующие этапы подготовки.
Например, публикацию можно представить набором полей: источник, адрес, время, текст, доступные показатели. Какие именно поля нужны, решает задача. Какие из них получится заполнить, зависит ещё и от источника. С таким набором уже можно работать программно, не открывая каждую страницу.
Мы не ограничивали систему одним типом площадок. В общий сбор входят обычные сайты, социальные сети, каналы и группы популярных мессенджеров. Источники выбираем под задачу и подключаем с учётом доступных способов получения данных.
Сотни миллионов страниц: что стоит за этой цифрой
Если задача укладывается в несколько знакомых сайтов, за ними можно следить вручную. Но у большого исследования или постоянного мониторинга совсем другой охват. Нужный материал может появиться там, куда человек в этот день просто не заглянул.
CyberData берёт этот обход на себя и сразу разбирает собранное. Не нужно выделять людей, которые будут открывать источники, переносить текст и приводить его к общему виду. Автоматизация освобождает время для самого исследования.
На этом масштабе важно отделить нужное от лишнего. Одна новость может появиться на десятках площадок, но для исследователя останется одним событием. Поэтому состав будущего датасета определяется задачей, а не числом загруженных страниц.
Для редакции: заметить событие, пока оно развивается
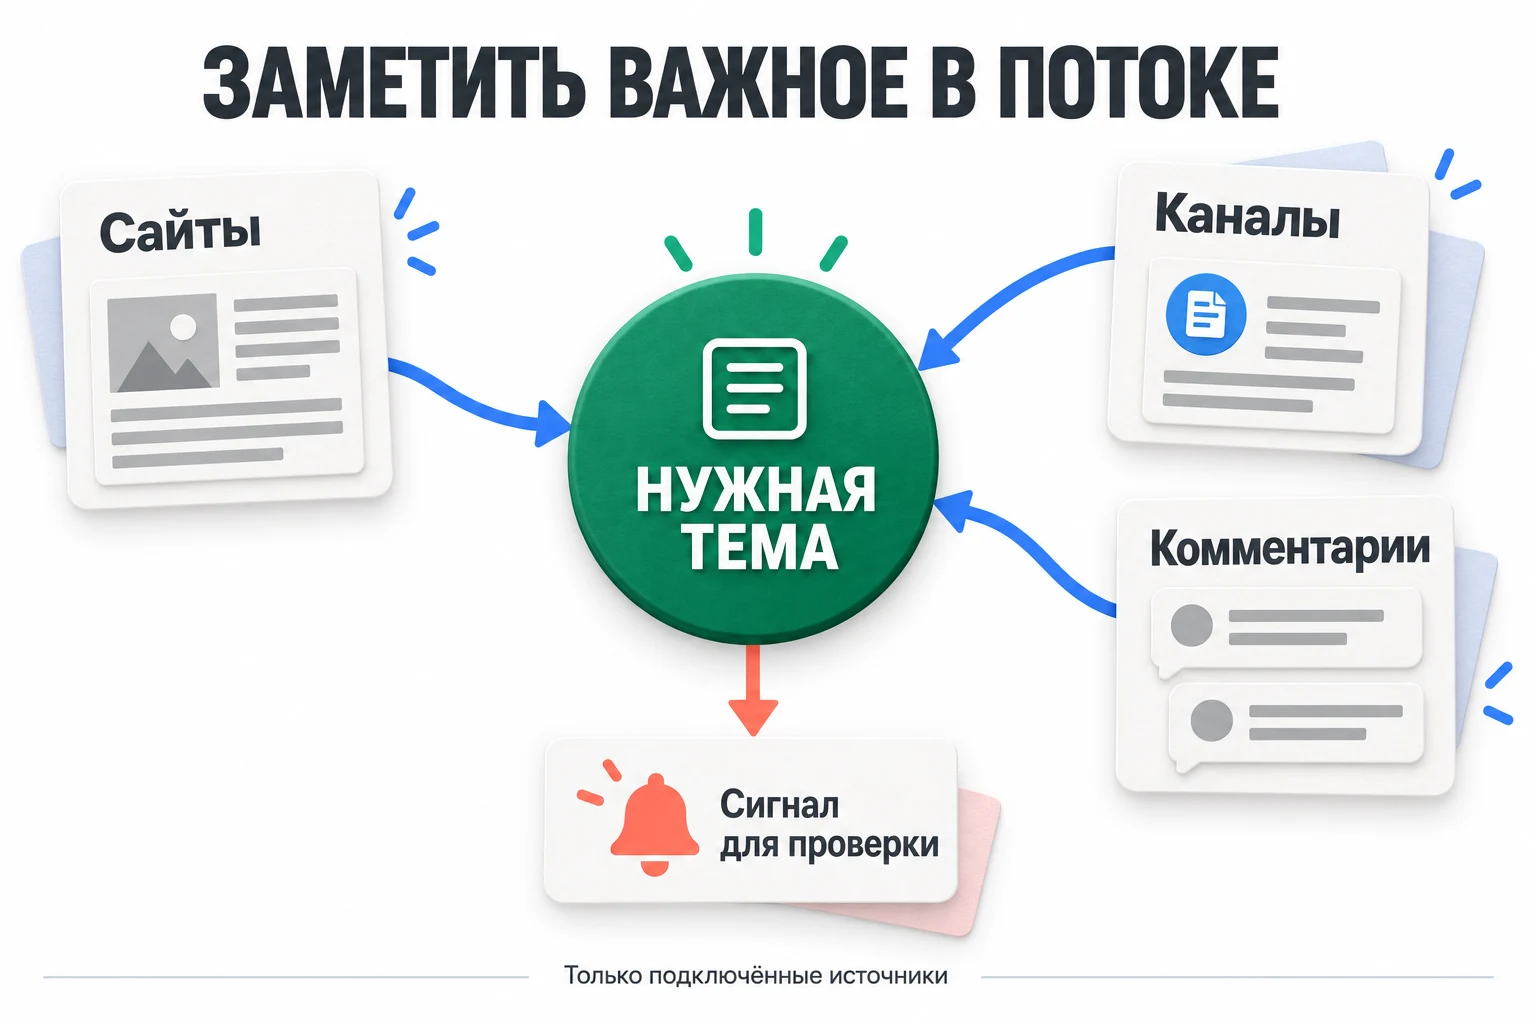
СМИ используют CyberData для наблюдения за событиями и ситуациями. Пользователь определяет, о чём хочет узнавать, а система отслеживает нужную информацию в подключённых источниках и может отправлять оповещения почти в реальном времени.
Так можно следить за развитием темы в регионе, сообщениями о работе предприятия или обсуждением решения, которое затрагивает жителей города. Редактору нужен не весь интернет за утро, а конкретный сигнал: по его теме появилось что-то, что стоит посмотреть.
Оповещение помогает редактору быстро выйти на материал. Насколько быстро, зависит от источника и частоты его обновления. Дальше начинается журналистская работа: найти первоисточник, подтвердить обстоятельства и решить, что можно публиковать.
Где о вас говорят, когда не пишут вам
Покупатель может подробно рассказать о неудачной покупке в комментариях к чужому посту и ни разу не обратиться к продавцу. У компании в поддержке всё спокойно, а обсуждение уже идёт. По собственному аккаунту этого не заметить.
В CyberData можно собирать упоминания компании или продукта из подключённых сайтов, постов и комментариев. Так в поле зрения попадают разговоры, за которыми сотрудникам пришлось бы отдельно ходить на разные площадки.
Возьмём изменение условий доставки. Чтобы понять реакцию покупателей, недостаточно знать, сколько раз за день написали название магазина. Придётся прочитать, что именно обсуждают. Одних беспокоит стоимость, другие не понимают, когда привезут заказ. Это разные вопросы, и решать их, скорее всего, будут разные сотрудники.
Собранные сообщения дают материал для такого разбора. Можно вернуться к публикации, посмотреть, на что отвечал человек, изучить обсуждение целиком. А уже потом выбирать действие: объяснить условия, проверить конкретный заказ или разобраться, почему проблема повторяется.
Эффективность публикаций тоже требует контекста
По доступным показателям CyberData позволяет наблюдать и за результатами публикаций: какие материалы привлекают внимание, как меняется реакция аудитории. Такой мониторинг можно включить в работу над конкретной задачей.
Здесь многое определяется самой площадкой: какие метрики она показывает и как их считает. Просмотр, реакция и комментарий говорят о разных действиях. Сравнивать их как одну и ту же величину нельзя, особенно между разными сервисами.
Такие данные полезны редакции при разборе тем и форматов, а бизнесу при оценке размещений. Но большое количество просмотров ещё не доказывает продажи. Для выводов о коммерческой эффективности потребуются данные о целевых действиях и расходах, которых в публичной публикации может не быть.
Почему это необходимо нам для работы с ИИ
В WowCash мы занимаемся искусственным интеллектом, в том числе обучением новых моделей. Поэтому вопрос «откуда брать данные?» для нас практический. Готовый набор может хорошо подходить одной задаче и совсем не отвечать другой. А корпус, собранный однажды, со временем перестаёт отражать происходящее.
Появляются новые компании и продукты. Меняется язык обсуждений. Событие, о котором вчера никто не говорил, сегодня заполняет новостную повестку. Нам нужен способ получать этот материал регулярно, а не всякий раз организовывать сбор с нуля.
Для этого и нужна CyberData. Система собирает информацию из подключённых источников и выдаёт её в структурах для дальнейшей обработки. Работа команды начинается с требований к нужному корпусу, а не с копирования страниц в таблицу.
Для одной задачи потребуются новостные тексты по определённой теме. Для другой интересны разные способы, которыми люди формулируют вопросы и описывают проблему. Третьей нужен материал для анализа того, как менялось обсуждение события. В каждом случае состав данных и правила отбора будут своими.
Когда данные уже собраны
С новостями хорошо видна разница между сбором и подготовкой датасета. Одну заметку могли перепечатать несколько сайтов. Для мониторинга полезно знать, где она появилась. А в обучающем наборе эти перепечатки могут оказаться лишними: нового материала они не добавляют. Одни и те же данные понадобятся двум задачам в разном виде.
Мы потому и не называем результат сбора готовым датасетом. Ещё нужно решить, что войдёт в обучение, проверить тексты и допустимость их использования. Может понадобиться убрать повторы, отобрать материалы без чувствительной информации или сделать разметку. Здесь нельзя раз и навсегда выбрать правила, подходящие любому проекту.
CyberData снимает с нас другую работу: поиск по источникам, сбор и приведение материала к нужной структуре. Дальше можно заниматься подготовкой набора и моделью. А когда понадобятся свежие публикации, за ними снова не придётся идти вручную.
Зачем WowCash собственная система сбора
Бывает, что готового набора по нужной теме просто нет. Или он есть, но собран давно, а нас интересует происходящее сейчас. Собственная система позволяет не подстраивать исследование под то, что удалось найти. Мы можем поставить задачу на сбор и получить материал из подключённых источников, уже разобранный для дальнейшей обработки.
Та же система пригодилась и там, где обучение модели вообще не требуется. Редакции нужен сигнал о событии, компании нужны упоминания продукта, аналитику материалы для сравнения. Сбор и структурирование позволяют перейти к этой работе быстрее.
Мы продолжаем развивать направление ИИ в WowCash, и CyberData для нас одна из его основ. Откуда взят материал, в каком виде он получен, достаточно ли он свежий для нашей задачи? Иметь собственную систему сбора означает уметь работать с этими вопросами ещё до начала обучения модели.