У покупателя простая задача: открыть каталог, выбрать город и увидеть подходящие предложения. А приложение в это время собирает карточку из нескольких таблиц, спрашивает соседние сервисы, считает показатели продавца и выясняет, к какому региону относится выбранная улица. Всё устроено логично. Только эта логика заново выполняется для каждого посетителя.
На небольшой нагрузке такое устройство может вполне устраивать. Позже выясняется, что серверы заняты прежде всего повторением одной и той же работы. Убрать её бывает выгоднее, чем ускорять каждую отдельную операцию.
В WowCash мы используем Codex и Claude Code для разработки, исследования кода и проверки гипотез. Но решения о том, какую работу система делает при каждом запросе, принимаем с учётом продукта и его нагрузки. Иногда это означает намеренно хранить лишние данные, отказаться от общей абстракции или подготовить отдельный путь для массовой операции. Агенту нужно объяснить причины: иначе полезную особенность проекта легко принять за недочёт.
Денормализация проекта: что мы имеем в виду
В строгом смысле денормализация относится к модели данных. Мы допускаем избыточность: например, сохраняем итог рядом с исходными записями, чтобы не вычислять его при каждом чтении. Взамен получаем дополнительную работу при обновлениях и обязанность следить за согласованностью.
На уровне проекта похожий выбор возникает далеко за пределами базы. Можно держать подготовленную карточку для каталога, копировать часть справочника в сервис, рассчитывать маршрут заранее, разделять модели чтения и записи. Даже немного похожего кода иногда разумнее оставить в двух независимых модулях, чем связать их универсальным компонентом с десятками исключений.
Не каждый такой приём правильно называть денормализацией. Индекс, отдельная колонка или специализированная функция сами по себе ею не являются. Здесь речь о более широком инженерном подходе: организовать систему под важные операции, осознанно заплатив за это избыточностью, подготовкой данных или дополнительными правилами сопровождения.
Лишняя копия может сократить работу при чтении. Но вместе с копией появляется вопрос: кто отвечает за её актуальность?
Быстрый ответ часто готовят до вопроса
Представим каталог, в котором посетители постоянно смотрят название компании, её город и количество активных предложений. Изменяются эти сведения заметно реже, чем открываются страницы. Собирать их заново на каждом просмотре необязательно: можно поддерживать отдельную модель чтения, уже удобную для выдачи.
Тогда изменение объявления запускает обновление подготовленных данных. Запрос посетителя читает короткую, предсказуемую структуру. Сложность никуда не исчезла: часть работы переехала с просмотра страницы на обработку изменений.
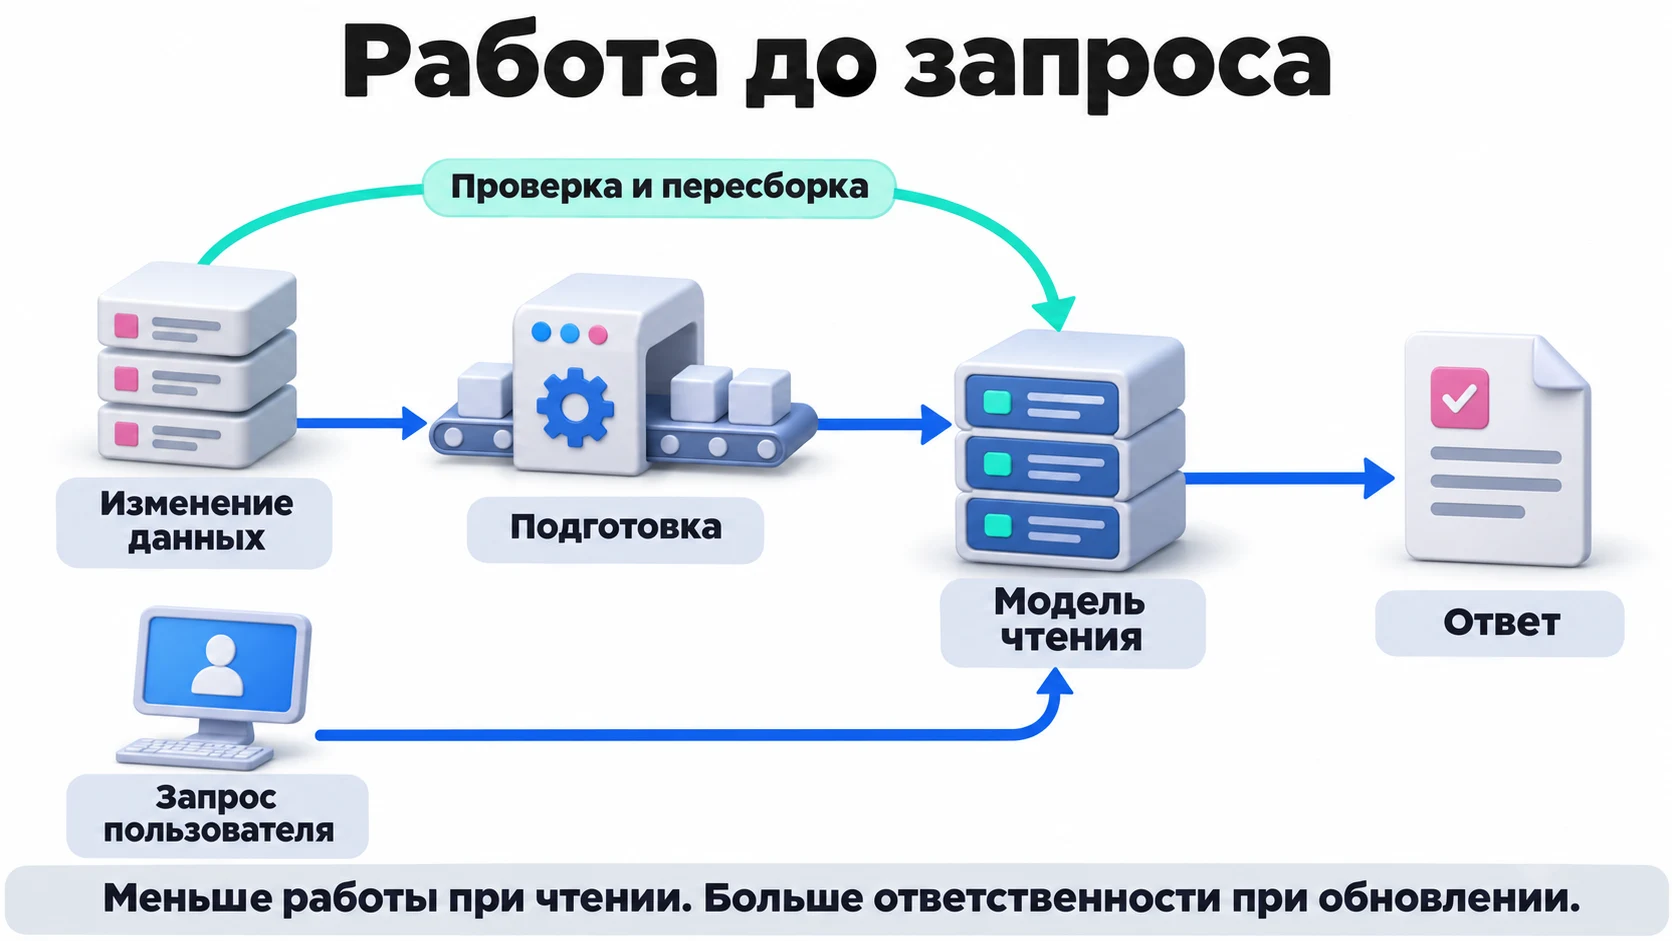
Такой подход полезен, когда соотношение чтения и записи это оправдывает. Если же почти каждое обращение меняет данные, а подготовка копий требует тяжёлых пересчётов, выигрыш может оказаться скромным или отрицательным. Понадобятся измерения обоих путей, а не только красивый график скорости выдачи.
Разделение моделей чтения и записи обсуждают в архитектуре CQRS. Для этого не обязательно сразу заводить отдельный кластер, шину событий и десяток сервисов. Иногда достаточно отдельной таблицы для чтения в той же базе. А иногда проще оставить исходную модель: у CQRS есть собственная цена сложности, и небольшому приложению она может быть ни к чему.
Где ещё можно убрать повторную работу
Локальный справочник вместо обязательного сетевого запроса
Допустим, нескольким сервисам нужны названия категорий и их признаки. Если справочник редко меняется, локальная копия может убрать постоянное обращение к общей службе. В результате меньше сетевых зависимостей на пути пользовательского запроса.
Однако право изменять справочник должно оставаться определённым. Копия не становится вторым независимым источником истины. Нужны версия данных, доставка изменений и понятное поведение, когда обновление задержалось. Для названия категории небольшое отставание иногда допустимо. Для решения о доступе пользователя такой компромисс может быть неприемлем.
Подготовленная выдача вместо сборки экрана по частям
Карточка в каталоге и подробная страница объекта решают разные задачи. Необязательно заставлять их проходить один и тот же универсальный конвейер. Для списка можно заранее собрать небольшой набор полей, а редкие подробности загружать по запросу.
Это касается и интерфейса. Данные для первого экрана, счётчики, рекомендации и тяжёлые подробности не всегда должны прибывать одновременно. Но перенос загрузки сам по себе не исправляет дорогую операцию: нужно отдельно понимать, какую работу мы исключили, какую отложили и что произойдёт, когда пользователь всё-таки откроет подробности.
Специальный путь вместо универсального механизма
Универсальный обработчик полезен, пока его гибкость помогает проекту. Если массовая операция проходит через десятки ненужных преобразований, у неё может появиться отдельная реализация. Например, для большой пакетной загрузки вместо вызова одиночного сценария для каждой записи.
Это не разрешение обойти проверку прав и данных или учёт изменений. Различаться может способ выполнения, но обязательные бизнес-правила сохраняются. Отдельный путь придётся тестировать и сопровождать; иначе ускорение сегодня станет двумя расходящимися реализациями завтра.
Небольшое дублирование кода вместо лишней зависимости
Два фрагмента похожи внешне, но принадлежат разным процессам и меняются по разным причинам. Объединять их только ради отсутствия повторов рискованно: вскоре общая функция может обрасти условиями для каждого потребителя. Небольшое осознанное дублирование иногда позволяет развивать модули независимо.
Сервер от двух похожих функций быстрее не станет. Выигрыш здесь другой: один модуль можно изменить, не задевая второй. Общую формулу расчёта денег или проверку безопасности, напротив, опасно копировать без единого контракта: последствия расхождений слишком велики.
Кейс WowCash: поиск в большом каталоге
В одном из наших проектов сайт получал сотни миллионов просмотров страниц в день. Поиск работал по большой базе PostgreSQL. Поисковые параметры мы вынесли в отдельные колонки, а для востребованных сочетаний фильтров создали составные индексы по двум или трём колонкам.
Индексы заняли дополнительное место, зато поиск стал требовать меньше ресурсов. Мы не перебирали все возможные пары и тройки полей: число комбинаций быстро растёт, и каждую новую структуру затем приходится обслуживать при записи. Отправной точкой были запросы, которыми пользуется продукт.
Например, в условном каталоге человек выбирает город, категорию и диапазон цены. Это ещё не готовое описание индекса. Один город даст несколько подходящих строк, другой гораздо больше; добавятся сортировка и особенности отбора. Поэтому важны порядок колонок в индексе и распределение данных. Возможности составных индексов описаны в документации PostgreSQL, а их пользу для конкретного поиска показывает план выполнения на данных проекта.
Колонки и индексы сами по себе не означают денормализацию. Здесь важен выбор структуры под частую операцию. Масштаб сайта мы приводим по опыту команды, не как сравнительный бенчмарк: просмотры страниц нельзя приравнять к SQL-запросам, среднесуточный поток не описывает пики, а такую же скорость на произвольной базе этот кейс не обещает.
Кейс WowCash: 50 миллионов локаций и диапазоны
В другом проекте мы работали со справочником примерно на 50 миллионов записей: страны, регионы, города, улицы. У каждого узла можно хранить родителя. Для вопросов о непосредственных детях этого достаточно, но нас часто интересовало всё, что находится внутри территории, через несколько уровней дерева.
Мы организовали идентификаторы так, чтобы каждому поддереву соответствовал вложенный диапазон. Принадлежность территории уже была заложена в расположение записей. Условно, Москва занимает диапазон от 100 000 до 300 000, а страна, внутри которой она находится, от 50 000 до 3 000 000. Числа здесь иллюстрируют устройство, а не раскрывают реальные идентификаторы справочника.
Получился отбор по границам диапазона, с которым умеет работать B-tree индекс. Для выборки только улиц добавляется фильтр по типу: внутри территории есть и другие записи. Объём результата при этом остаётся прежним. Если найден миллион строк, их всё равно придётся прочитать и передать.
Быстрое чтение зависит от порядка в справочнике: внутри границ должны находиться все записи своего поддерева и ни одной из чужой ветви. Добавление города, перенос улицы или исчерпание свободного места затрагивают уже не отдельный запрос, а устройство данных. Перенос большой ветви может потребовать существенного перестроения; внешние ссылки при этом не должны ломаться.
Для нового проекта мы отдельно рассматривали бы стабильный ID объекта и ключ его положения в дереве. Ссылки тогда привязаны к постоянному идентификатору, а диапазоны меняются отдельно. Перестроение всё ещё стоит ресурсов, но меньше затрагивает связанные данные. Это один из вариантов для сравнения с рекурсивными запросами и другими моделями иерархий, а не рецепт для любого справочника.
Самый неприятный тест: данные обновились не везде
У подготовленной выдачи есть уязвимое место: обновление должно до неё дойти. Обработчик может упасть, очередь отстать, а событие прийти повторно. Тогда исходное объявление уже снято, но каталог его показывает. Или счётчик увеличивается дважды. Или новое название компании видно только на части экранов.
С такими ситуациями и приходится разбираться после решения «будем хранить готовую копию». У неё есть исходная запись и владелец, которому разрешены изменения. Есть допустимое отставание: для счётчика оно может быть одним, для остатка товара другим. Повтор события не должен повторно увеличивать итог, а запоздавшее обновление не должно затирать более свежую версию.
Поэтому эксплуатация включает сверку с источником и пересборку производных данных. Важно не только получить правильную новую копию, но и переключить на неё чтение без частично готовой выдачи. А перед подтверждением покупки система заново проверяет остаток и права в источнике, который отвечает за эту операцию. Быстрый каталог не принимает решение о списании денег.
Отдельная проблема возникает, когда запись сохранилась, а уведомление о ней не ушло. Для этого разрыва есть transactional outbox: основное изменение и запись о событии фиксируются в одной транзакции, доставка происходит позже. Повторы и порядок обработки всё равно остаются заботой системы. Одной распределённой транзакции на весь процесс из этого не получается.
Кеш помогает, но не объясняет стоимость запроса
В описанных проектах наш ориентир такой: основной путь выдерживает согласованную нагрузку без прикладного кеша готовых ответов, а кеширование даёт дополнительный запас. Это установка для конкретных задач. Системы, существенно опирающиеся на кеш, тоже существуют, просто у них другие условия эксплуатации.
При обычном cache-aside промах возвращает приложение к исходной работе. Популярное сочетание фильтров уже прогрето и отвечает быстро, новое ещё потребует обращения к основному хранилищу. По одному удачному графику этого различия не увидеть. Холодный запуск и массовые промахи подробно разобраны в AWS Builders' Library.
Для проверки основного пути мы обходим кеш ответов на протяжении всего теста. Разовая очистка не подходит: кеш начнёт заполняться и снова примет часть нагрузки. Но отключать ради этого весь Redis тоже неверно, если там работают сессии или очереди.
Буферы СУБД, индексы и постоянные модели чтения остаются на месте. Последние тоже содержат подготовленные данные. Отличие здесь определяется не названием, а устройством: откуда они берутся, как обновляются и из чего пересобираются. Назвать хранилище моделью чтения вместо кеша недостаточно, чтобы исчез риск устаревших копий.
Если база не рассчитана на полный поток после отказа кеша, проекту нужен другой согласованный режим: ограничение нагрузки, временное сокращение части функций или иной способ деградации. Просто отправить все запросы в базу означает перенести перегрузку, а не обеспечить отказоустойчивость.
Что рассказать Codex и Claude Code до начала работы
Агент видит два похожих метода и предлагает объединить их. Или находит повторяющееся поле и убирает «лишнее» хранение. Возможно, для обычного приложения это было бы разумно. Но из кода не всегда видно, что отдельный путь появился после нагрузочного теста, а повторяющееся поле снимает сетевой запрос с каждой карточки.
Запишите решение там, где его найдут при работе с модулем: в короткой архитектурной заметке и проектных инструкциях. Нужны причина выбора, ограничения и способ проверки. Фразы «не менять, так быстрее» мало: она не помогает понять, где решение действует и когда его пора пересмотреть.
Постановку задачи можно начать так:
Проектируем выдачу большого каталога. Ниже приведены объём данных, пиковые чтения и записи, основные фильтры, бюджет ресурсов и требования к задержкам. Для этого проекта основной путь должен выдерживать расчётный профиль без кеша ответов. Предложи варианты, включая отдельную модель чтения. Сравни стоимость чтения, обновлений и восстановления. Не удаляй намеренные копии и специализированные пути ради унификации без измерений. Отдельно укажи источник истины, допустимое отставание, обработку повторов и план пересборки. Сначала проверь рискованные предположения на прототипе, затем предложи реализацию.
Вместо слов «ниже приведены» действительно нужны характеристики проекта. Если пока есть только оценка, обозначьте её как предположение. Важно проверить и то, что произойдёт, если поток или частота обновлений окажутся выше ожидаемых.
Codex и Claude Code могут помочь сравнить варианты, собрать нагрузочный сценарий и найти слабые места. Но написанные агентом аргументы не заменяют эксперимент. О том, как передавать правила проекта без лишних переделок, мы подробнее рассказывали в статье об экономии лимитов Codex и Claude Code.
Проверяем выигрыш, а не впечатление от схемы
Начните с операции, ради которой затеяли изменения. Возьмите репрезентативные данные: большой город и маленький, популярную категорию и редкую, узкий фильтр и широкий. Запустите чтение одновременно с обновлениями и характерными фоновыми задачами. Одиночный быстрый запрос мало говорит о поведении всего приложения.
Измеряйте пропускную способность, ошибки и задержки, в том числе p95 и p99: время, в которое укладываются соответственно 95 и 99 процентов запросов в выбранной выборке. Для подготовленных моделей отдельно смотрите отставание обновлений, время пересборки и расхождения. Быстрая, но устаревшая выдача может не соответствовать требованиям продукта.
В PostgreSQL для исследования запросов пригодится EXPLAIN (ANALYZE, BUFFERS). Учтите: ANALYZE действительно выполняет запрос, в том числе изменяющий данные. Такие проверки проводят в подходящем тестовом окружении; подробности есть в документации EXPLAIN.
После ускорения поиска нас интересует, сколько теперь занимает запись. После появления копии — удастся ли восстановить её после сбоя. Если работа ушла в фон, проверяем, успевает ли очередь обрабатывать поступающие изменения. При одинаковых ресурсах и условиях будет видно, получили ли мы запас производительности или просто перенесли перегрузку в другое место.
Необычное решение должно быть объяснимым
Денормализация не нужна каждому проекту. Иногда один хороший индекс, исправленный запрос или отказ от лишнего сетевого вызова решает задачу без новой подсистемы. Начинать стоит с измерений, а не с желания построить что-нибудь сложное.
Но и универсальность не бесплатна. В высоконагруженной системе бывает разумно потратить место, подготовить данные заранее и оставить отдельную реализацию частого сценария. При условии, что команда понимает, зачем это сделано, как поддерживается корректность и при какой нагрузке выбор перестанет себя оправдывать.
В наших проектах эта работа начинается с поведения продукта, а не с генерации таблиц. Как мы организуем границы системы и взаимодействие людей с агентами, показано в кейсе AdminCore и единого API. Если нужно спроектировать или пересмотреть архитектуру вашего сервиса, можно обсудить задачу с командой WowCash.
Хороший результат здесь вполне конкретен: пользователь не ждёт ненужных вычислений, обновления доходят до своих копий, а следующий разработчик понимает, почему система устроена именно так.