За полтора года мы собрали 4 000 000 новостных статей, объединённых в 728 162 сюжета Дзена. Сейчас заканчиваем разметку этого корпуса и готовимся обучать компактную ИИ-модель для СМИ. Её задача: помогать редакции разбирать входящий поток, находить связанные публикации и замечать, когда в знакомой истории действительно появилось что-то новое.
Модель пока нельзя скачать: обучение и проверка ещё впереди. Зато подготовка данных уже позволяет предметно говорить о её задачах. И главная трудность здесь не в том, чтобы найти два похожих заголовка.
Пятнадцать пересказов и одно важное уточнение
Представим, что пятнадцать изданий пересказали одно заявление ведомства. Где-то поменяли заголовок, где-то добавили справку. Редактор уже прочитал исходное сообщение и примерно понимает, что увидит в остальных. Но в следующей заметке появляется новый комментарий. Её нельзя отбросить вместе с повторами.
Вот эту разницу мы и хотим научить модель замечать. Пересказы можно показать одной группой, не потеряв ссылки на источники. Материал с новым фактом стоит выделить. А похожую новость из другого города вообще не следует присоединять к этой группе.
Совпадающие слова здесь ненадёжный ориентир. Заметки о двух пожарах бывают почти одинаковыми, а сообщения об аварии и восстановлении воды написаны совсем по-разному. В первом случае это разные происшествия. Во втором вполне может оказаться одна история, дошедшая до следующего этапа.
Четыре миллиона статей полезны не только своим объёмом
В корпусе собраны публикации разных источников по сюжетам Дзена. Одна история в нём может быть представлена короткой заметкой, подробным пересказом, комментарием, уточнением или опровержением. Часть материалов пересказывает одно событие, в других появляются новые обстоятельства. Для обучения важно различать эти случаи.
Впрочем, готовая группировка не снимает работу по разметке. 728 162 сюжета не означают 728 162 точно разграниченных события. Внутри большого сюжета могут оказаться обсуждение законопроекта, его принятие и вступление в силу. У этих новостей общая история, но разные действия и даты.
Поэтому исходные группы приходится разбирать дальше. Мы сохраняем тексты и метаданные, очищаем содержательную часть от технического мусора, учитываем повторы. При этом выбросить все рерайты было бы ошибкой: разные пересказы как раз нужны, чтобы учить модель узнавать событие при другой подаче.
Размер архива сам по себе эту работу не заменит. Подробнее о подготовке обучающих примеров рассказывали в статье о датасетах и нейросетях под задачи бизнеса.
Одно событие, продолжение истории и просто похожая новость
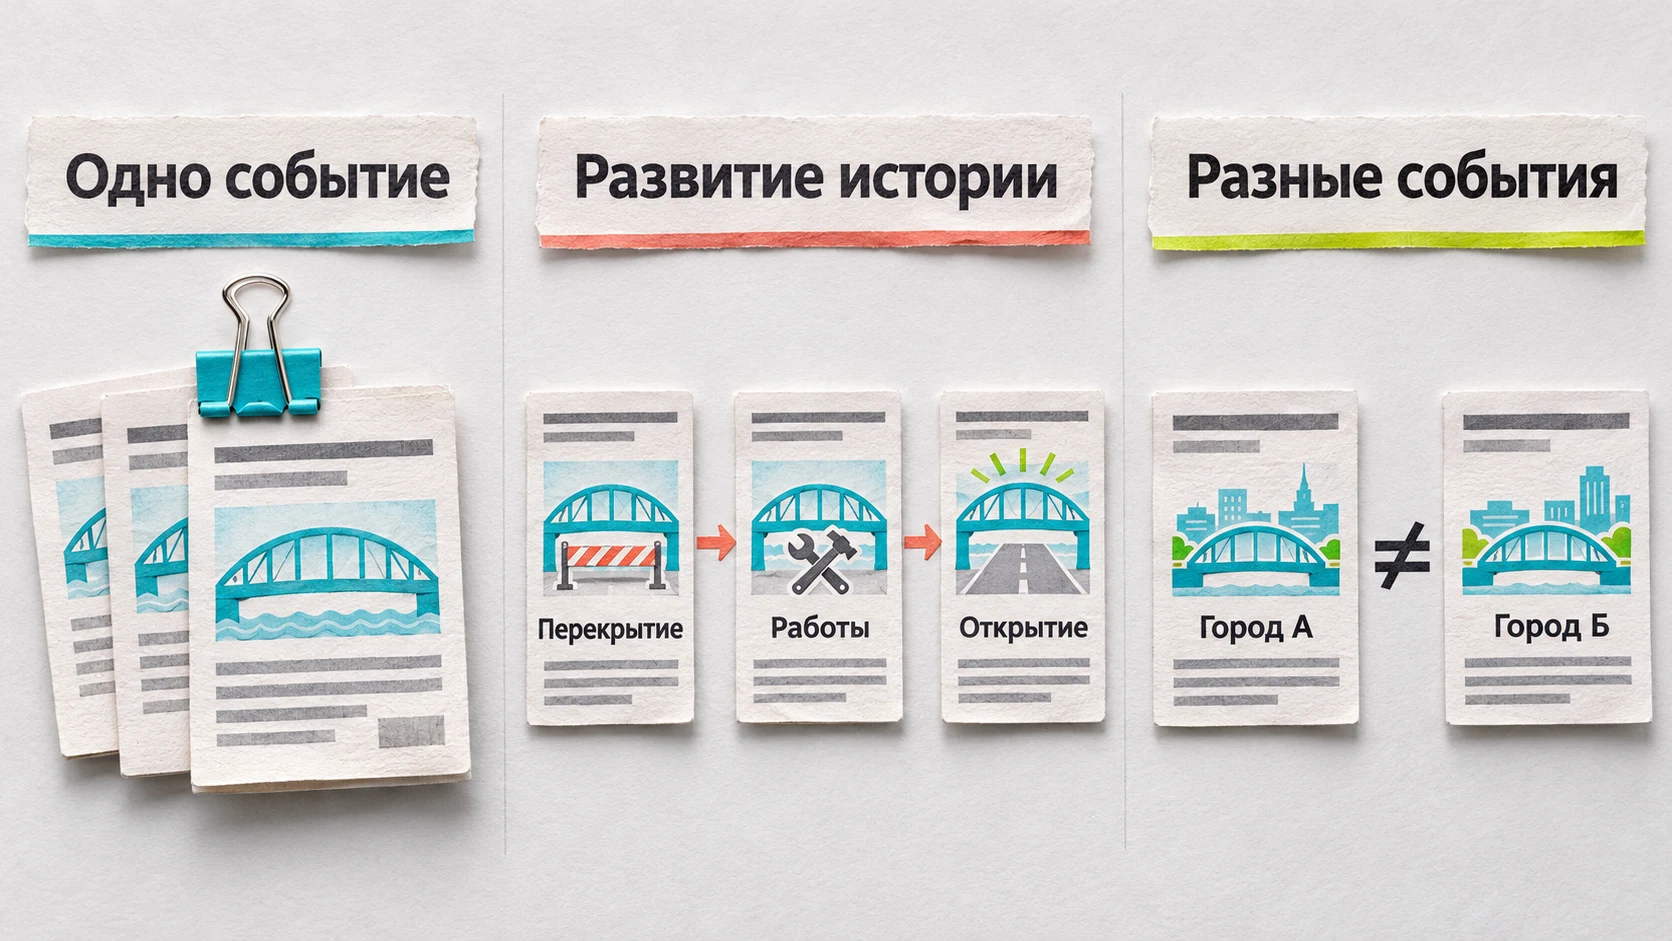
Мы разделяем три вида связи. Ответа «тексты похожи» редактору мало: нужно понимать, почему их предлагают читать вместе.
- Одно событие. Два издания сообщили о принятии одного решения. Заголовки отличаются, но действие, участники и обстоятельства совпадают.
- Развитие истории. Сначала дорогу перекрыли, затем ограничения продлили, позже движение восстановили. Материалы связаны, однако каждый описывает отдельный этап.
- Разные события. Через месяц на той же дороге снова произошло происшествие. Знакомое место и похожие слова не превращают его в продолжение предыдущего.
Для разметки особенно интересны пары, в которых легко ошибиться. Два населённых пункта с одинаковым названием. Почти одинаковые аварии в разные дни. Один и тот же спикер, который сделал два разных заявления. На простых совпадениях можно получить приличный результат и всё же не научиться различать такие случаи.
Что мы размечаем внутри публикации
Чтобы сравнить две новости, сначала нужно разобрать каждую по отдельности. В разметке мы смотрим не только на тему и знакомые имена.
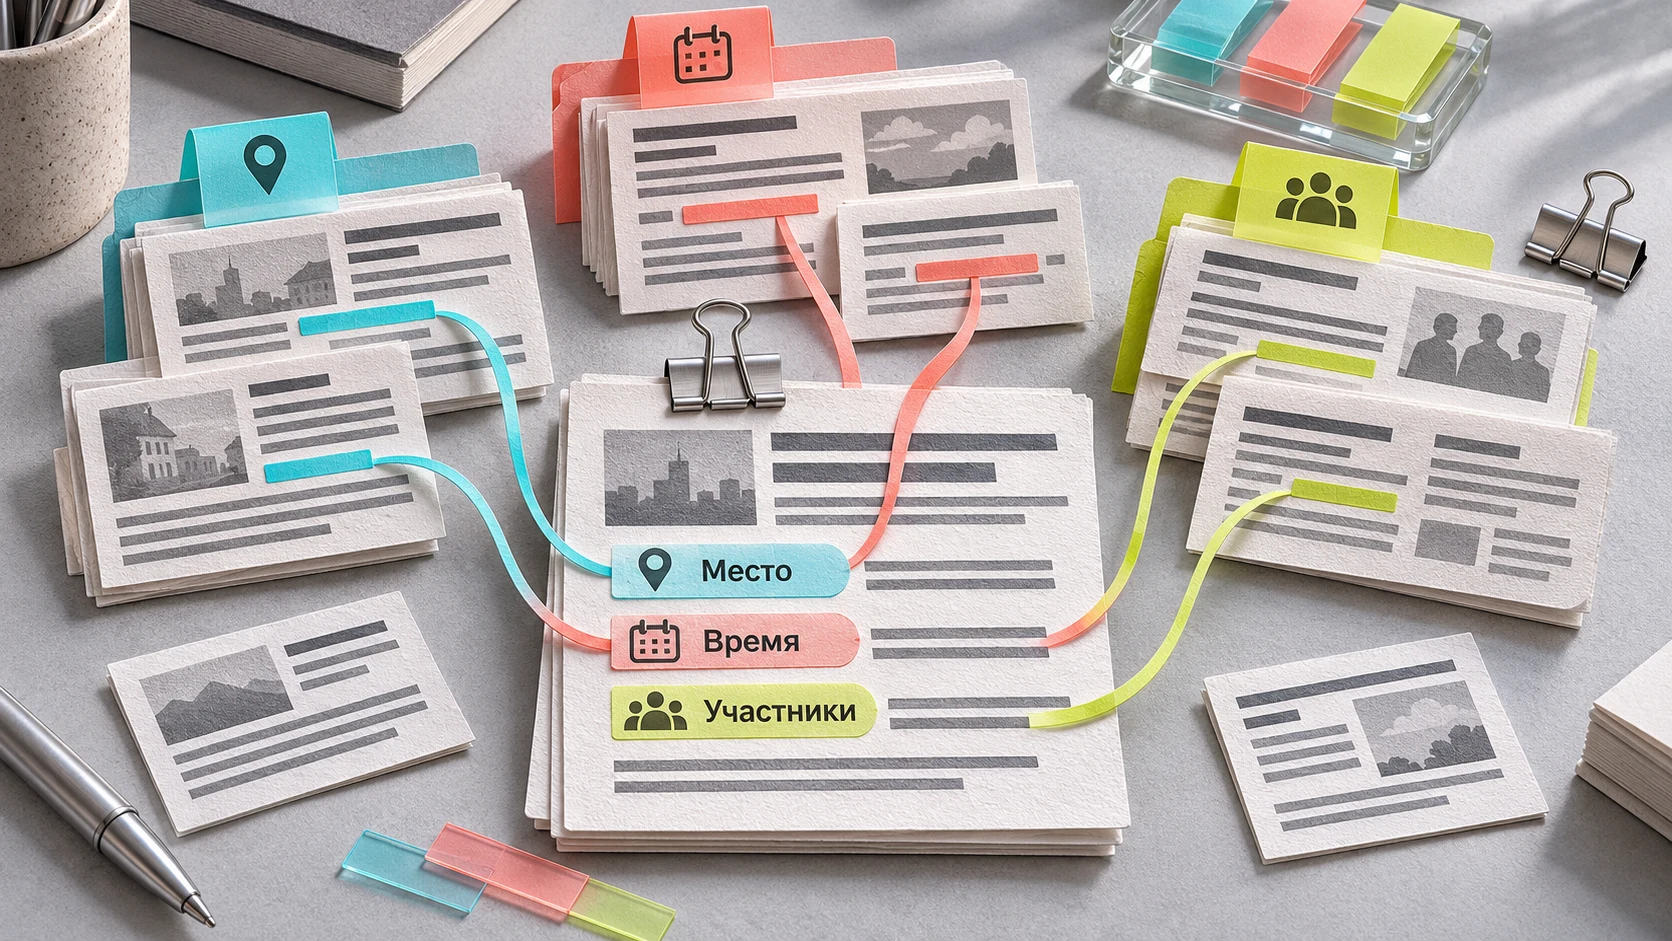
Событие и участники
Что стало поводом для публикации: само происшествие, решение, начало работ или заявление? Это главное действие. Рядом могут стоять справка и отсылки к старым историям, их отмечаем отдельно. С именами похожая задача: участник события, комментатор и представитель ведомства могут упоминаться в одной заметке, но играют разные роли.
Место события и территория его значения
Новость о происшествии в Туле может содержать комментарий из Казани и подпись московского корреспондента. Для географической привязки нужны не все три города подряд, а понимание их роли в сообщении.
Отдельный вопрос: на кого распространяется новость. Решение, принятое в одном месте, может касаться целого региона или страны. В разметке разделяем географию события и территорию, для которой оно имеет значение.
Эта задача знакома нам по работе над GlobalMap и географической привязкой новостей. Но нынешний анонс относится к модели, которую ещё предстоит обучить и проверить, а не к уже выпущенной функции карты.
Время, тема и статус сообщения
Заметка вышла сегодня. Значит ли это, что событие тоже произошло сегодня? Нет: автор мог вернуться к прошлому или рассказать о планах. Эти случаи размечаем отдельно от даты публикации. Если известен только год, не дописываем месяц и день. Слова «вчера» и «на следующей неделе» связываем с доступным временным контекстом.
Одной публикации может понадобиться несколько тематических меток. Отключение электричества относится и к ЖКХ, и к происшествиям. Изменение автобусного маршрута касается транспорта и городской жизни. В разметке учитываем основное направление и дополнительные категории.
Есть ещё статус информации. «Планируют открыть», «открыли» и «опровергли сообщение об открытии» нельзя складывать в одно утверждение. Даже когда речь об одном здании. В разметке сохраняем эту разницу и отмечаем, кто сообщил сведения.
Срочность, критичность и неопределённость
Срочность отвечает на вопрос, насколько быстро стоит обратить внимание на сообщение в момент его публикации. Критичность связана с тяжестью последствий для людей, инфраструктуры и работы территории. Громкий заголовок сам по себе не должен повышать обе оценки.
А если в заметке вообще нет места или даты? Такое бывает, и нам нужен допустимый ответ «сведений недостаточно». Поле можно оставить пустым, спорную связь отправить на проверку. Заполнять всё только ради аккуратной карточки мы не хотим.
Какой результат мы хотим получать от модели
На входе будут заголовок, текст и необходимые метаданные. Редактору на выходе нужна карточка новости: событие, участники, место, время, тема, масштаб и оценки срочности и критичности. Рядом с извлечёнными сведениями хотим показывать фрагменты исходного текста. Если модель указала город, должно быть видно, почему она выбрала именно его.
Для сравнения статей потребуется другой ответ: это повтор, продолжение истории или самостоятельное событие? Ещё одна задача: заметить, что изменилось. Уточнили последствия, опровергли раннее сообщение, подтвердили восстановление работы. Здесь важен сам новый факт, а не то, насколько сильно редакция переписала заголовок.
Сравнивать каждую новую статью со всеми четырьмя миллионами записей подряд мы не собираемся. Сначала система должна отобрать вероятно связанные материалы. Затем уже можно подробнее сравнить их содержание, время и место. Иначе работа с большим архивом окажется слишком дорогим способом найти несколько подходящих публикаций.
Зачем редакции компактная специализированная модель
Новостной поток приходит каждый день, а не один раз для демонстрации. Статьи приходится обрабатывать по мере появления, иногда заново после правок. Значит, учитывать нужно и задержку, и затраты на постоянную работу.
Мы выбрали узкий набор задач: классификация, извлечение сведений, сравнение текстов. Для них нужен короткий, предсказуемый ответ. Длинное рассуждение о заметке не заменит правильно заполненных полей. Также планируем обработку материалов пачками.
Насколько лёгкой и быстрой получится модель, покажут измерения. Пока не называем число параметров, оборудование и количество новостей в секунду: обучение ещё не проведено.
Планируем API, через который редакция сможет получать результаты в своей системе и использовать их в поиске, фильтрах, уведомлениях и группировке материалов. Локальное развёртывание тоже рассматриваем; окончательные требования станут понятны после обучения и тестов.
Как не получить красивую оценку на знакомых текстах
В проверке есть ловушка: один пересказ новости попал в обучение, а почти такой же текст другого издания оказался в тесте. Результат выглядит хорошо. Но что именно мы проверили: работу с незнакомым событием или узнавание уже встречавшегося материала?
Поэтому публикации об одном событии будем относить к одной выборке, не распределяя близкие версии между обучением и проверкой. Оценку проведём на материалах и событиях, которые модель не видела при обучении.
Результат разберём по типам ошибок:
- Ошибочные объединения: разные события попали в одну группу.
- Пропущенные связи: система не распознала публикации об одном событии или его продолжении.
- Ошибки места и времени: выбрано случайное упоминание города, прошлое принято за настоящее или план за совершившееся действие.
- Оценки срочности и критичности: соответствуют ли они согласованным определениям, а не эмоциональности подачи.
Эти ошибки неравноценны. Пропущенная связь может оставить в ленте лишний повтор. А неверное объединение смешает сведения о двух разных происшествиях. Пороги автоматического объединения будем выбирать после проверки, учитывая эту разницу.
Совпадение нескольких публикаций ещё не доказывает достоверность их содержания.
Модель поможет искать утверждения, расхождения и связи. Но она не сможет подтвердить новость лишь потому, что о ней написали несколько изданий. Проверка фактов и решение о публикации остаются за редакцией.
Что уже сделано и когда можно будет попробовать
Заканчиваем разметку. Дальше предстоят обучение, разбор ошибок и измерение производительности.
После обучения и проверки планируем опубликовать модель в блоге WowCash. Вместе с ней подготовим инструкцию по запуску, примеры работы и результаты тестирования. Тогда редакции смогут оценить инструмент на собственных материалах, а не по описанию возможностей.
В конечном счёте задача довольно практическая. Меньше времени тратить на перебор одинаковых сообщений и поиск продолжений. Больше оставлять на то, ради чего редакция и работает: проверять факты, замечать важные изменения и рассказывать о них читателю.