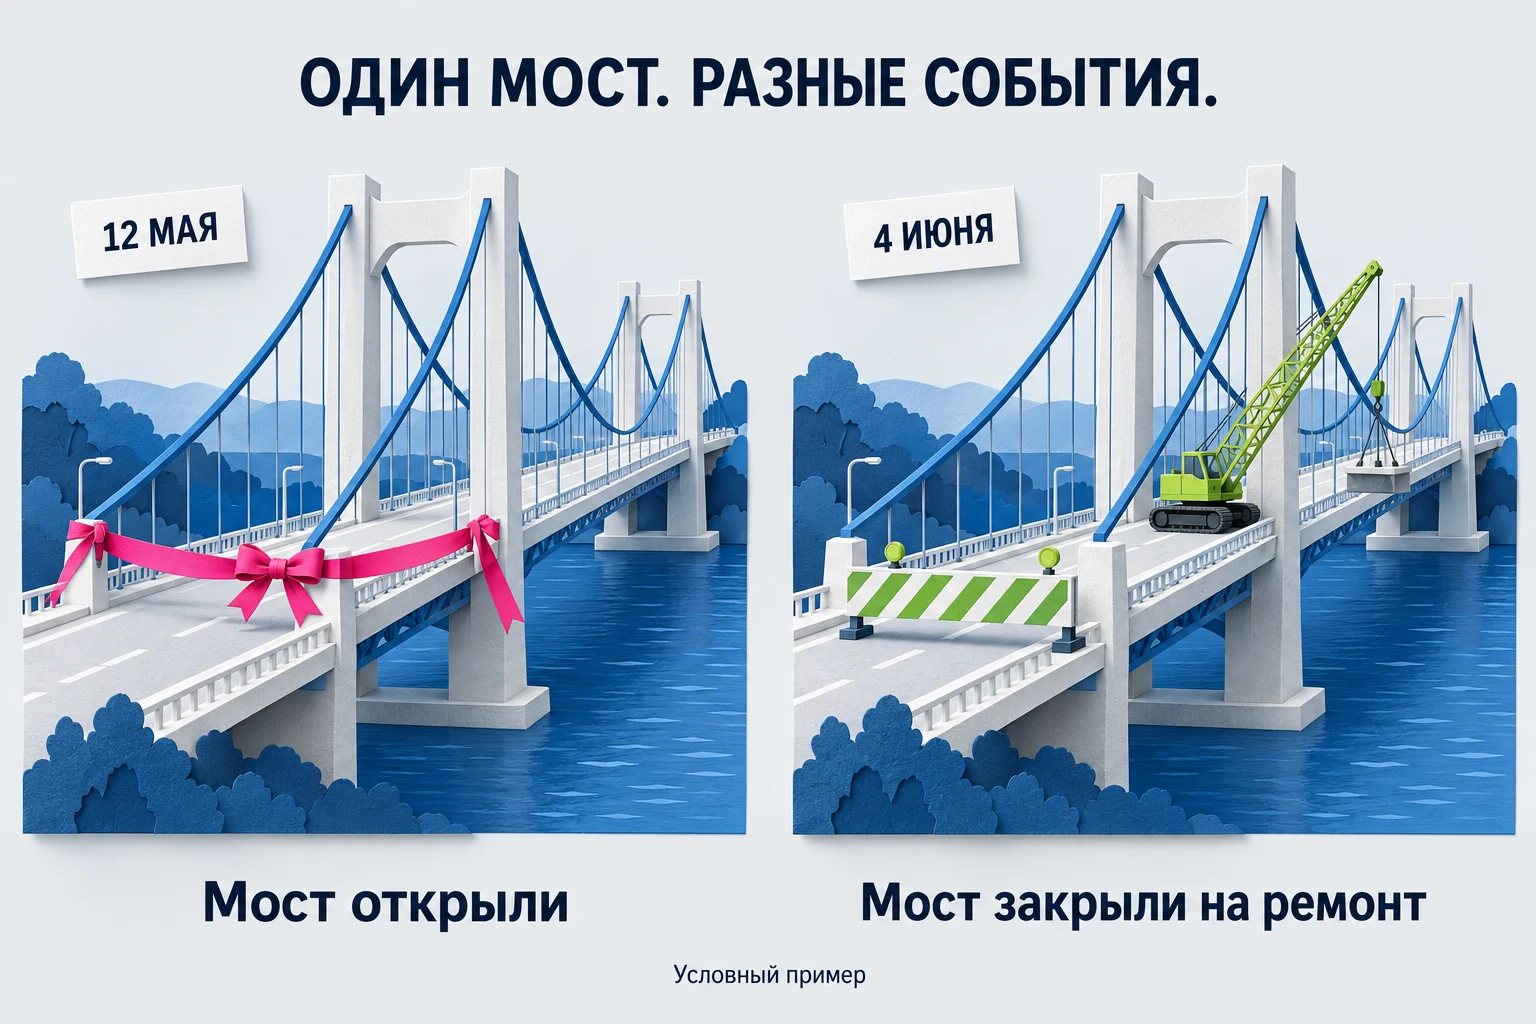
Одна фамилия, один город, почти одинаковые слова в заголовках. Кажется, новости можно объединить. Но в первой человек сделал заявление, а во второй через несколько дней пришёл на встречу. Это разные события. Бывает и наоборот: редакции по-разному описывают одну историю, и по заголовкам её не сразу узнаешь.
Для новостного сервиса обе ошибки неприятны. В одном случае сюжет распадается на несколько карточек, в другом в общую карточку попадают события, которым там не место. Мы сделали Laya, чтобы решать именно эту задачу: определять, относятся ли два заголовка к одному новостному сюжету.
Первая версия хорошо проходила обычные тесты, но ошибалась на похожих новостях. Рассказываем, как мы пересобрали данные, дообучили модель с LoRA и запустили сервис, который на нашем внутреннем стенде обрабатывал около 300 запросов в секунду.
Что должна различать Laya
Семантическая близость полезна, но сама по себе не отвечает на наш вопрос. «Похожи ли тексты» и «описывают ли они одно и то же событие» требуют разных решений. Важны участники, действие, время, место и объект новости. Иногда одна деталь меняет смысл, хотя все остальные слова совпадают.
В качестве внешнего ориентира мы использовали JEV. Нам нужна была собственная модель с управляемыми данными, порогами и версиями. Воспроизводить поведение JEV буквально мы не собирались: прежде всего требовалось разобраться с ошибками в нашем новостном потоке.
Базовая модель и LoRA
В основу Laya легла многоязычная модель примерно на 421 млн параметров. Она уже умела сопоставлять смысл текстов. Разницу между «очень похоже» и «одно событие» пришлось учить отдельно.
Для этого мы выбрали LoRA. Метод добавляет обучаемые низкоранговые матрицы, не требуя обновлять все веса базовой модели. Так эксперименты требуют меньше памяти, а версии адаптера проще хранить и разворачивать. Можно быстрее проверить новую подборку примеров, не повторяя полное обучение модели.
Дальше всё упиралось в пары заголовков. На разных формулировках одной новости модель учится объединять сюжеты. На близких, но разных событиях учится не объединять. В первой версии с этой второй частью было хуже.
Первая версия: тесты хорошие, склейки неправильные
Источником заголовков для первого набора стали новостные данные Дзена. До очистки на обучение приходилось около 7,48 млн пар. На валидацию и тест выделили ещё по 0,94 млн. После очистки осталось примерно 6,13 млн обучающих пар и по 0,77 млн в двух проверочных частях.
За несколько эпох обучения мы сохраняли промежуточные контрольные точки, чтобы не начинать заново после остановки. Следили за функцией потерь. Проверка по стандартным метрикам выглядела обнадёживающе: с явными совпадениями Laya справлялась.
А вот на потоке заголовков она стала склеивать лишнее. Для уверенного ответа «один сюжет» ей порой хватало фамилии, организации или города. В других случаях совпадала тема, но происходило в новостях разное.
Именно эти ошибки нам и пришлось разбирать. По автоматически собранному тесту всё выглядело хорошо, а продукт получал неверно объединённые сюжеты. Для редакции такая склейка была вполне конкретной проблемой.
Hard negatives: похожие новости, разные события
Можно было взять побольше случайных новостей и составить из них отрицательные пары. Но для Laya большинство таких задач были слишком простыми: разные герои, слова, темы. Они не помогали разобраться с уверенными ложными совпадениями.
Поэтому для следующего обучения мы отбирали hard negatives, то есть похожие заголовки о разных событиях. Например, о разных заявлениях одного человека или похожих происшествиях, случившихся в разные даты. Отдельно собирали новости из одного региона, которые нельзя было объединять только по месту действия.
В набор также попадали пары почти с одинаковыми ключевыми словами, но разным фактом. И, конечно, собственные ошибки первой Laya: заголовки, которым она уже присвоила высокую вероятность совпадения, хотя общей истории за ними не было.
На таких парах пришлось учиться отличать само событие. Узнать общую тему было недостаточно.
Что вошло во вторую версию
Для v2 мы пересобрали данные с учётом ошибок первой модели. По внутренним материалам проекта, набор включал около 2 549 411 статей, или 2,55 млн, и 117 141 новостного сюжета. Из них сформировали примерно 4 693 915 положительных пар, или 4,69 млн. Отрицательную часть дополнили примерами из реальной работы Laya.
Обучение перестало быть разовой процедурой. Мы запускали модель на потоке, собирали ложные совпадения и пропущенные совпадения, отбирали полезные для обучения ошибки и проверяли следующую версию на тех же сложных случаях.
После дообучения LoRA v2 модель стала осторожнее с ложными совпадениями. Очевидные одинаковые сюжеты она по-прежнему определяла уверенно. При этом лучше разделяла новости об одних людях и на одну тему, если события были разными.
Вот что изменилось по сравнению с первой версией:
- Очевидные совпадения. Хорошо определялись в первой версии и сохранились во второй.
- Похожие, но разные новости. Первая версия часто склеивала их; v2 заметно лучше разделяет.
- Пограничные случаи. Излишняя уверенность первой модели сменилась более осторожным решением.
- Работа с ошибками. Вместо статичного набора мы получили постоянное пополнение сложными примерами.
- Сравнение с JEV. Первая версия заметно уступала ориентиру. Вторая оказалась лучше на части нашей внутренней сложной выборки.
Последний результат нельзя переносить на любые данные. Мы сравнивали модели на сценариях своего продукта, особенно на риске ошибочной склейки. Это не общий рейтинг и не доказательство превосходства Laya над JEV в других задачах.
Как модель стала сервисом
После обучения оставалось наладить загрузку модели, параллельную обработку запросов и измерение задержки. Мы развернули отдельные сервисы для базовой и LoRA-версии Laya.
HTTP-метод /predict принимает два заголовка. В ответе приходят решение same_story, вероятность совпадения, идентификатор версии модели и время обработки запроса.
Для новостной системы это обычный внутренний API. Через него удобно сравнивать версии, проводить A/B-проверки и постепенно менять пороги, не переделывая основной процесс обработки новостей.
Около 300 запросов в секунду: что именно мы измерили
После оптимизации сервинга наш внутренний стенд показал производительность порядка 300 запросов в секунду. На нём использовались серийные потребительские GeForce RTX 5060, а не специализированные ускорители для дата-центров.
Такие видеокарты можно использовать в обычной настольной рабочей станции. Для пилотного запуска не обязательно сразу строить инфраструктуру на профессиональных ускорителях. Но из этого не следует, что любая рабочая станция покажет наши 300 запросов в секунду.
Это результат конкретного внутреннего теста, а не обещание скорости на одной RTX 5060. Число GPU в этом кейсе не указано. На производительность также влияют размер пакета запросов, длина заголовков, формат вычислений, параллелизм, тайм-ауты и подготовка входных данных.
Для нашей задачи такая пропускная способность полезна при массовой проверке кандидатов на объединение и повторной обработке больших массивов. Модель работает внутри собственной инфраструктуры: каждый запрос не нужно отправлять во внешний API.
Что мы вынесли из работы над Laya
Главный прирост качества принёс подбор ошибок, а не механическое увеличение датасета. Мы увидели, какие именно события модель путает, и смогли вернуться к ним в следующем обучении.
Теперь команда контролирует формирование пар, данные, пороги, версии адаптера и сервис, который выдаёт ответы. Ошибка в рабочем потоке может стать обучающим примером. Новую версию можно сравнить с предыдущей и развернуть локально.
Этот порядок работы мы используем как основу для кастомных моделей:
- Определить, какой ответ нужен продукту и какая ошибка обходится дороже.
- Собрать реальные примеры, очистить их и разделить на обучение, валидацию и тест.
- Обучить базовую версию и проверить её по нескольким признакам качества.
- Пройти реальные сценарии, отдельно разобрать ложные срабатывания, пропуски и пограничные случаи.
- Добавить сложные примеры, дообучить модель и сравнить версии с внешним ориентиром на одинаковых наборах.
- Измерить задержку и пропускную способность, подготовить API и масштабирование.
За пределами новостей похожим способом можно работать с классификацией обращений, поиском дублей или сопоставлением товаров. Среди других возможных задач: антифрод, модерация, анализ документов, ранжирование, семантический поиск и выделение сущностей. В этом кейсе мы их не проверяли; здесь речь о том, куда ещё можно перенести подход к обучению.
Следующий шаг
Теперь нам нужно пополнять набор сложных отрицательных пар из рабочего потока. Будем разбирать ошибки по типам и подбирать пороги: для разных режимов кластеризации они могут отличаться.
Можно сократить и число обращений к Laya. Сначала более дешёвый поиск отбирает кандидатов, потом модель проверяет только близкие пары заголовков. Так мы не тратим её вычисления на заведомо далёкие новости. Это направление дальнейшей работы, а не описание уже измеренного ускорения.
Сам цикл у команды уже есть: нашли ошибку, подготовили данные, обучили версию, проверили и развернули локальный сервис. Следующие изменения будем проводить так же.
Данные и источники
Числа о датасете и скорости, а также оценки качества взяты из внутренних материалов команды Laya. Публичного воспроизводимого сравнения этот кейс не заменяет. Для него понадобятся конфигурация стенда и число GPU, размер пакета запросов, формат вычислений и длина входа. Кроме того, нужно опубликовать методику измерения задержки и состав тестовой выборки.
- Hu E. et al. LoRA: Low-Rank Adaptation of Large Language Models, arXiv:2106.09685. Описание метода адаптации модели.
- NVIDIA: GeForce RTX 5060 Family. Официальные спецификации потребительских видеокарт.
- Valve: Steam Hardware & Software Survey. В августе 2026 года доля настольной RTX 5060 в опросе составляла 3,16%. Это не основание утверждать, что такая карта «есть почти у каждого». Страница обновляется; здесь указаны данные за август, сохранённые в исходном материале.