Список источников готов. Есть сайты, отраслевые СМИ, публичные каналы. Осталось собрать материалы, и можно делать аналитику или обучать модель? На практике здесь начинается отдельная работа. На одном сайте текст спрятан среди навигации, на другом дата указана иначе, в канале новость появилась раньше, чем в издании. Ссылки уже собраны, а пользоваться данными ещё нельзя.
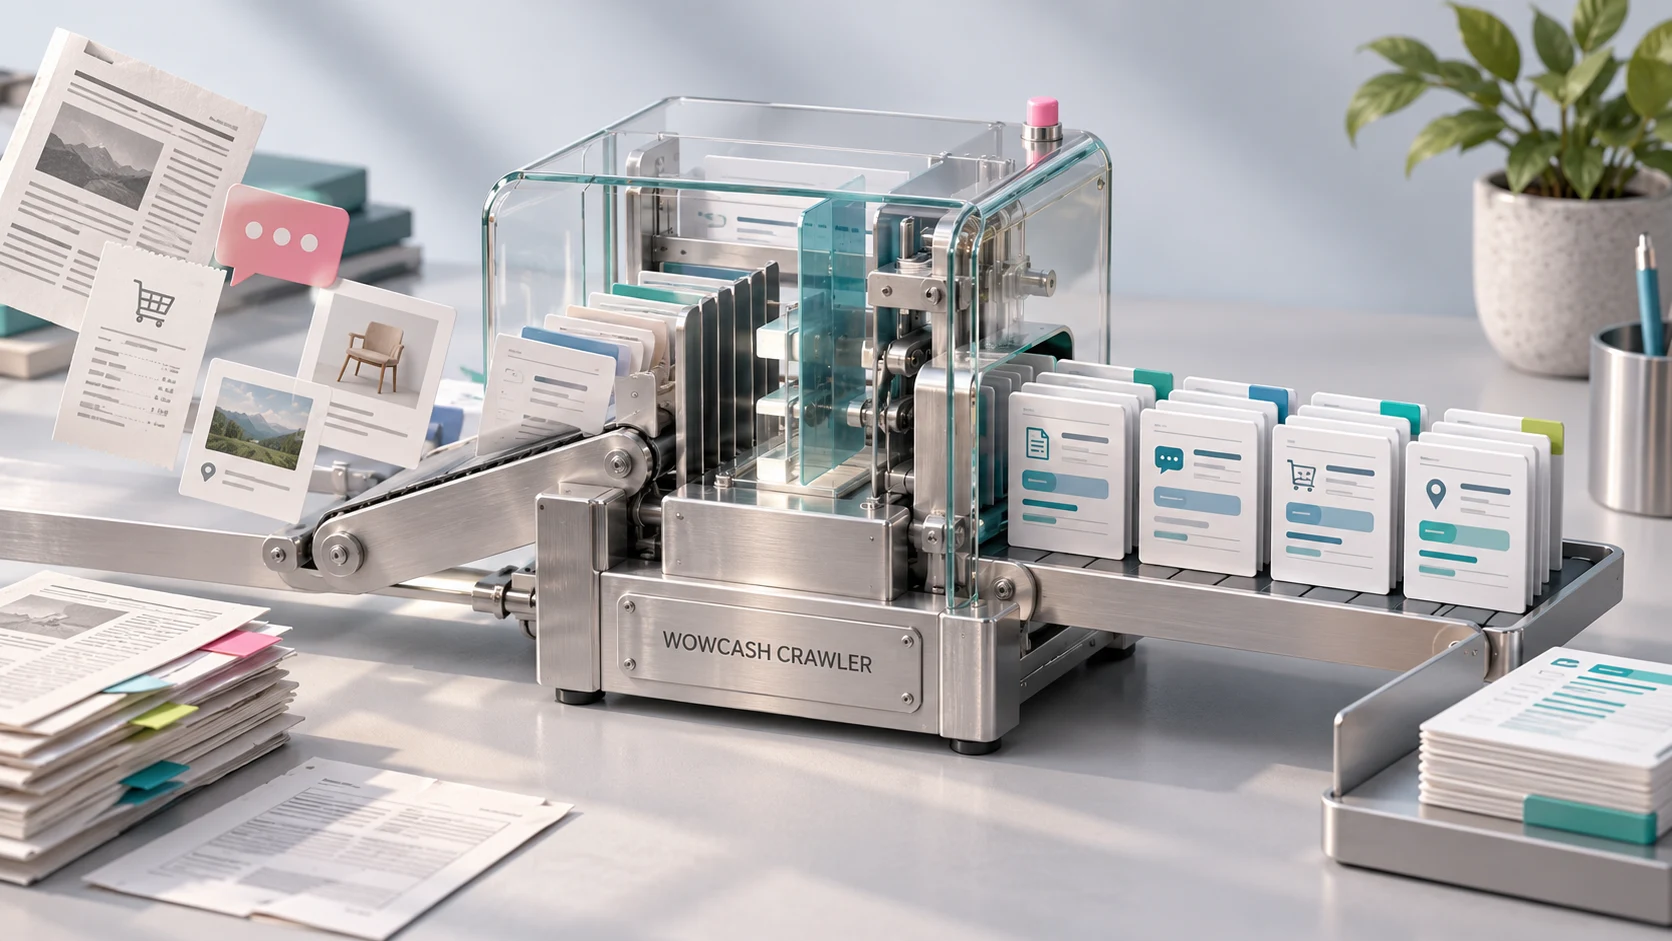
Для этой работы мы развиваем WowCash Crawler. Система собирает материалы из согласованных источников и готовит их к дальнейшему использованию: от исходных текстов до записей с нужными полями. Наша инфраструктура обрабатывает сотни гигабайт разнородных данных ежедневно. Это общий масштаб потока, а не объём, который необходимо покупать каждому клиенту. Для исследования может хватить небольшой тематической выборки.
Сбор данных начинается с вопроса, а не со списка сайтов
Запрос «соберите новости о рынке» слишком широк, чтобы по нему принять результат. Рынок какой страны? Нужны сообщения о новых продуктах или изменения цен? Следует сохранять полный текст или достаточно заголовка, источника и даты? Ответы меняют и подбор площадок, и устройство будущего датасета.
Поэтому сначала разбираем, куда попадут данные. Редакции нужна лента для поиска инфоповодов. Аналитической команде требуется история наблюдений. Разработчики модели могут искать корпус с определённой лексикой и примерами редких категорий. Даже при одинаковом списке сайтов это будут разные поставки.
Договариваемся о языках, тематике, периоде и географии. И сразу смотрим на пример записи. Именно на нём часто обнаруживается важная деталь: скажем, аналитик собирался сравнивать публикации по времени, а нужной даты в выбранном источнике нет.
Что собирает WowCash Crawler
В основе потока находятся новости, материалы СМИ, страницы сайтов и сообщения публичных каналов в мессенджерах. К ним могут добавляться публикации компаний, отраслевые сведения, доступная отчётность и рыночные показатели. Состав зависит от конкретной задачи и фактической доступности источников.
Под заказ рассматриваем и более узкие массивы: открытые товарные каталоги с ценами и характеристиками, отзывы, вакансии, объявления о недвижимости, тендеры, справочные материалы и документацию. У каждого такого набора свои поля. Цена без валюты и даты наблюдения мало говорит об изменении предложения. Вакансия без региона плохо подходит для сравнения рынков труда.
Речь идёт о доступных материалах и согласованных площадках, а не о закрытых переписках или чужих личных кабинетах. Для каждого проекта обсуждаем источники, условия использования и состав поставки. Публичность страницы не заменяет эту проверку.
Исходные материалы или готовые записи
Если у клиента есть собственная команда обработки данных, ей могут быть нужны исходные тексты, сохранённые страницы или документы. Вместе с ними важны сведения об источнике и времени получения. Такой массив можно снова обработать другим алгоритмом: сегодня выделить названия компаний, позже подготовить примеры для классификатора.
Когда данные должны сразу попадать в продукт, передаём записи с согласованными полями. У новости это могут быть заголовок, текст, дата, источник и ссылка. У товарного предложения: название, категория, цена и доступные характеристики. Для события можно выделить время, место и участников, если они указаны в материале и входят в задание.
Формат подбираем под принимающую систему: например, JSON, JSONL, CSV или текстовый корпус. Название формата само по себе ничего не решает. Важнее договориться, что означает каждое поле, как представлены пропуски и какие сведения действительно можно получить из источника. Отсутствующую цену нельзя незаметно превращать в ноль.
Разовая выборка и постоянный поток решают разные задачи
Для первого эксперимента удобно заказать один датасет за согласованный период. Команда загружает его в свою среду, проверяет гипотезу и понимает, нужны ли другие источники. Не обязательно начинать с непрерывной поставки, если пока неизвестно, пригоден ли сам материал.
Когда задача повторяется, можно договориться о регулярных выгрузках. Они подходят для обновления аналитического хранилища, периодических отчётов и подготовки новых обучающих выборок. Для информационной ленты или мониторинга нужен иной режим: новые записи передаются по мере обнаружения и обработки.
Такой поток обновляется постоянно, но «в реальном времени» не означает одинаковую задержку для всех площадок. Частота зависит от источника и согласованного режима поставки. Для запуска продукта бывает полезно соединить два варианта: сначала загрузить доступную историю, затем получать новые материалы.
Что можно построить на этих данных
Редакция может объединить отраслевые СМИ и публичные каналы в рабочую ленту. Рядом с публикацией сохраняются её источник и дата, а журналист решает, что проверять и о чём писать. PR-команда использует тематический поток для наблюдения за упоминаниями бренда. Правила уведомлений и оценку значимости сообщений можно реализовать уже в системе клиента.
Для интернет-магазина полезен другой срез: открытые предложения, ассортимент и характеристики. Продуктовой команде могут потребоваться отзывы и обсуждения, чтобы исследовать повторяющиеся жалобы. Разработчику отраслевого ассистента нужен корпус документов, по которым система будет искать ответы. Это примеры применения, а не обещание готовой аналитики внутри каждой выгрузки.
Данные для обучения нейросетей требуют дополнительной договорённости. Сбор текстов ещё не даёт готовых меток, баланса классов и независимой тестовой выборки. Разметка, очистка и разделение массива входят в отдельный состав подготовки. Для RAG, где модель отвечает с опорой на найденные документы, особенно важны пригодность текстов для поиска и возможность вернуться к источнику.
Почему мы сами используем этот поток
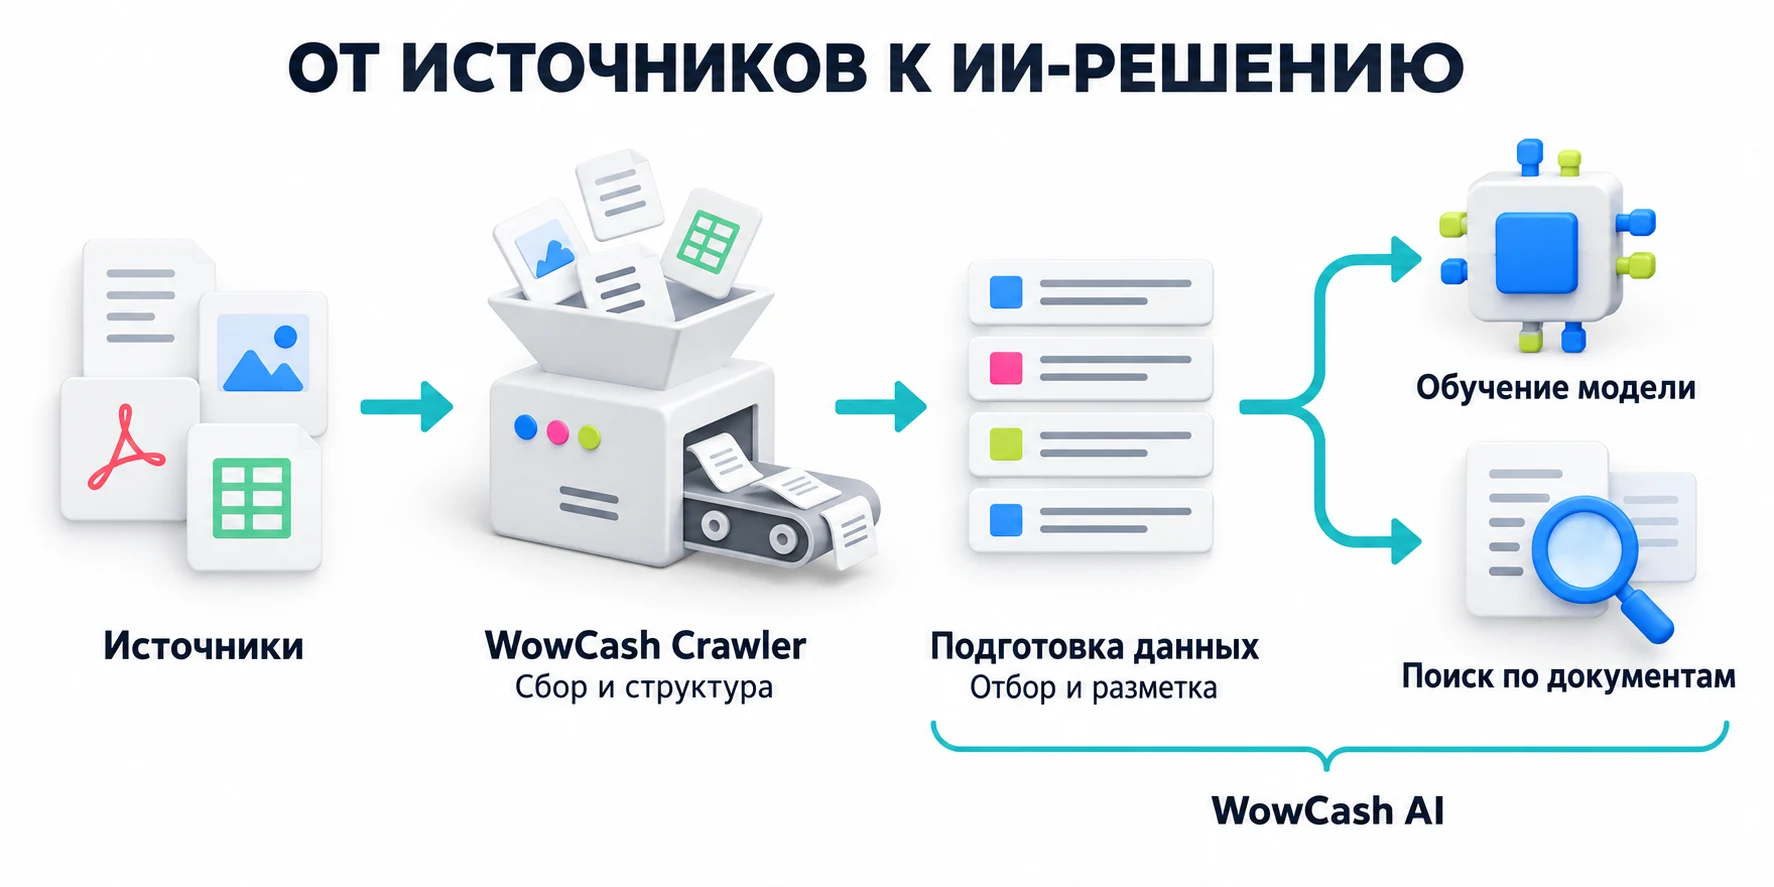
Материалы из WowCash Crawler постоянно поступают в WowCash AI, наш проект аналитики и работы с нейросетевыми моделями. Там данные становятся обучающими выборками, материалом для исследований и проверки качества моделей. О следующем этапе мы рассказали отдельно: как WowCash AI готовит датасеты и обучает нейросети под задачи бизнеса.
У вас может быть своя команда, которая уже умеет обрабатывать данные и обучать модели. Тогда WowCash AI в проекте вовсе не нужен: заказываете сбор, получаете согласованный массив и дальше работаете с ним у себя. Мы используем оба сервиса вместе, но не требуем того же от клиента.
Как обсудить сбор данных на заказ
Покажите, с чем собираетесь работать. Подойдёт даже пустая таблица с названиями столбцов: по ней быстрее понять, какие сведения нужны и что из них удастся получить. Добавьте несколько источников, если уже выбрали их, и объясните, зачем собираете материал. Отдельно скажите, важны ли прошлые публикации или достаточно новых.
Дальше проверяем эту идею на образце. Вы сможете посмотреть, попадают ли в него нужные тексты, хватает ли полей и удобно ли загружать записи в вашу систему. После этого есть смысл обсуждать большой объём и график обновлений. От источников, сложности обработки, количества данных и частоты поставок будет зависеть стоимость.
WowCash Crawler и WowCash AI доступны только клиентам, свободного входа в эти системы нет. Начать разговор можно через заявку на сайте WowCash. Готовое техническое задание необязательно: достаточно описать, что сейчас приходится собирать вручную или каких данных не хватает вашему продукту.