Коэффициент на сайте уже изменился, а в выгрузке осталось старое значение. Аналитическая система продолжает считать, но работает с прошлой картиной. Для нашего клиента такая пауза была существенной: ему требовались обновления, а не очередной снимок страниц.
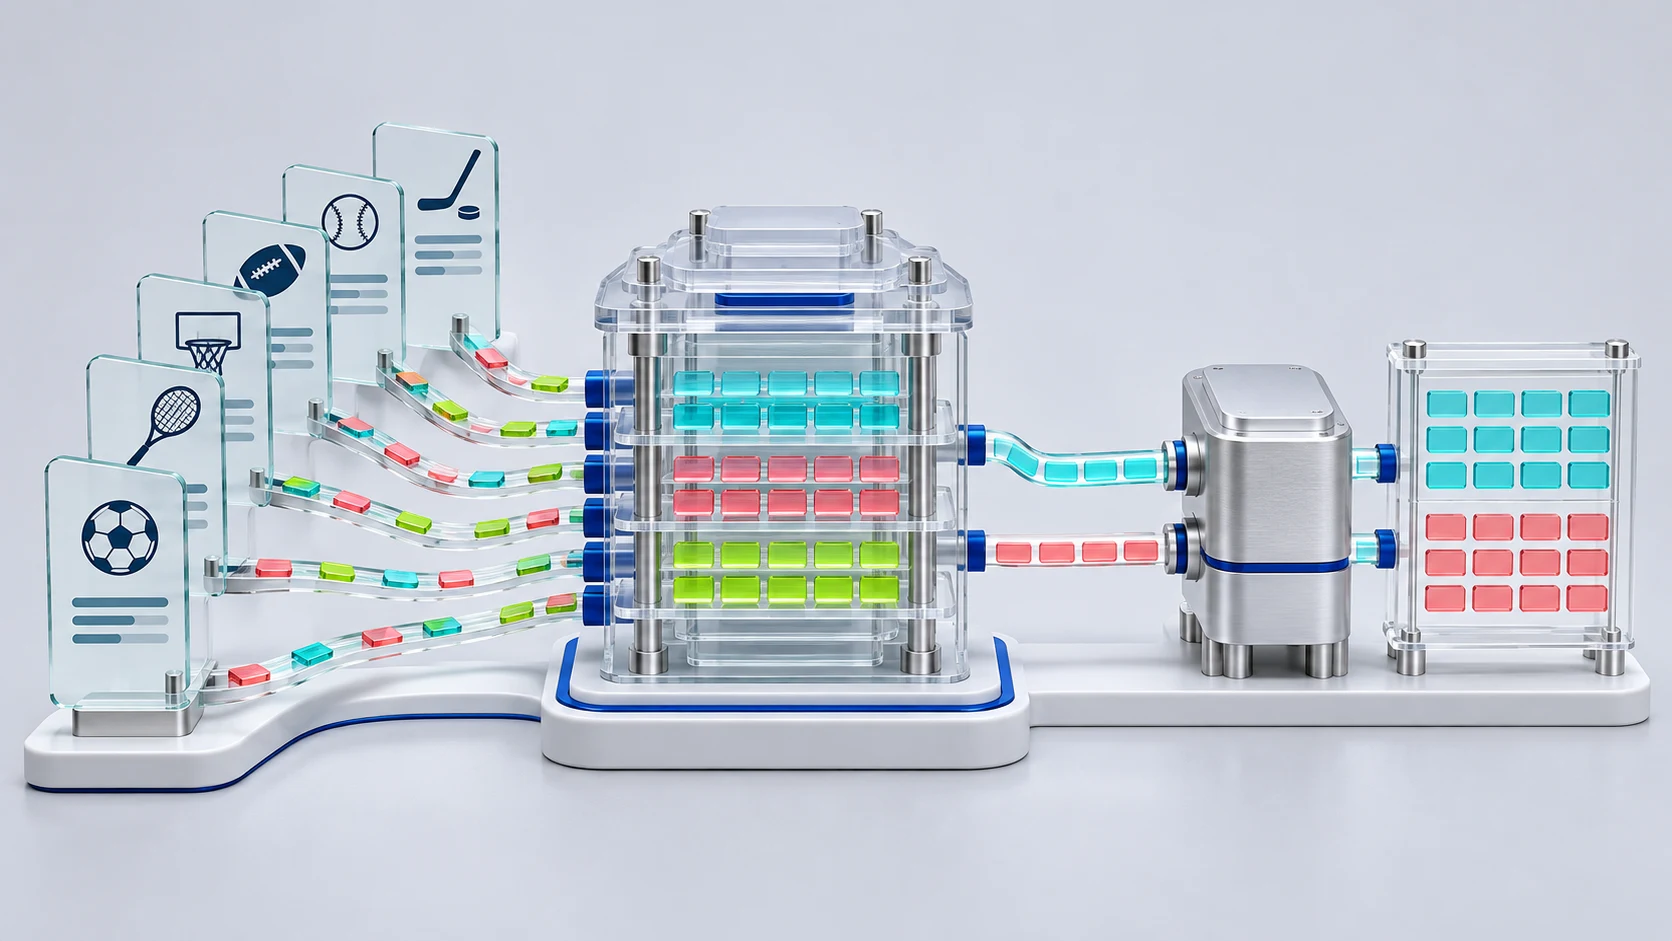
Клиенту нужен был непрерывный поток информации более чем с 30 российских и зарубежных букмекерских площадок. Коэффициенты, результаты матчей, все виды спорта, представленные у подключённых источников. Данные требовалось передавать в собственную систему заказчика для аналитики, подготовки материалов и обработки с помощью ИИ.
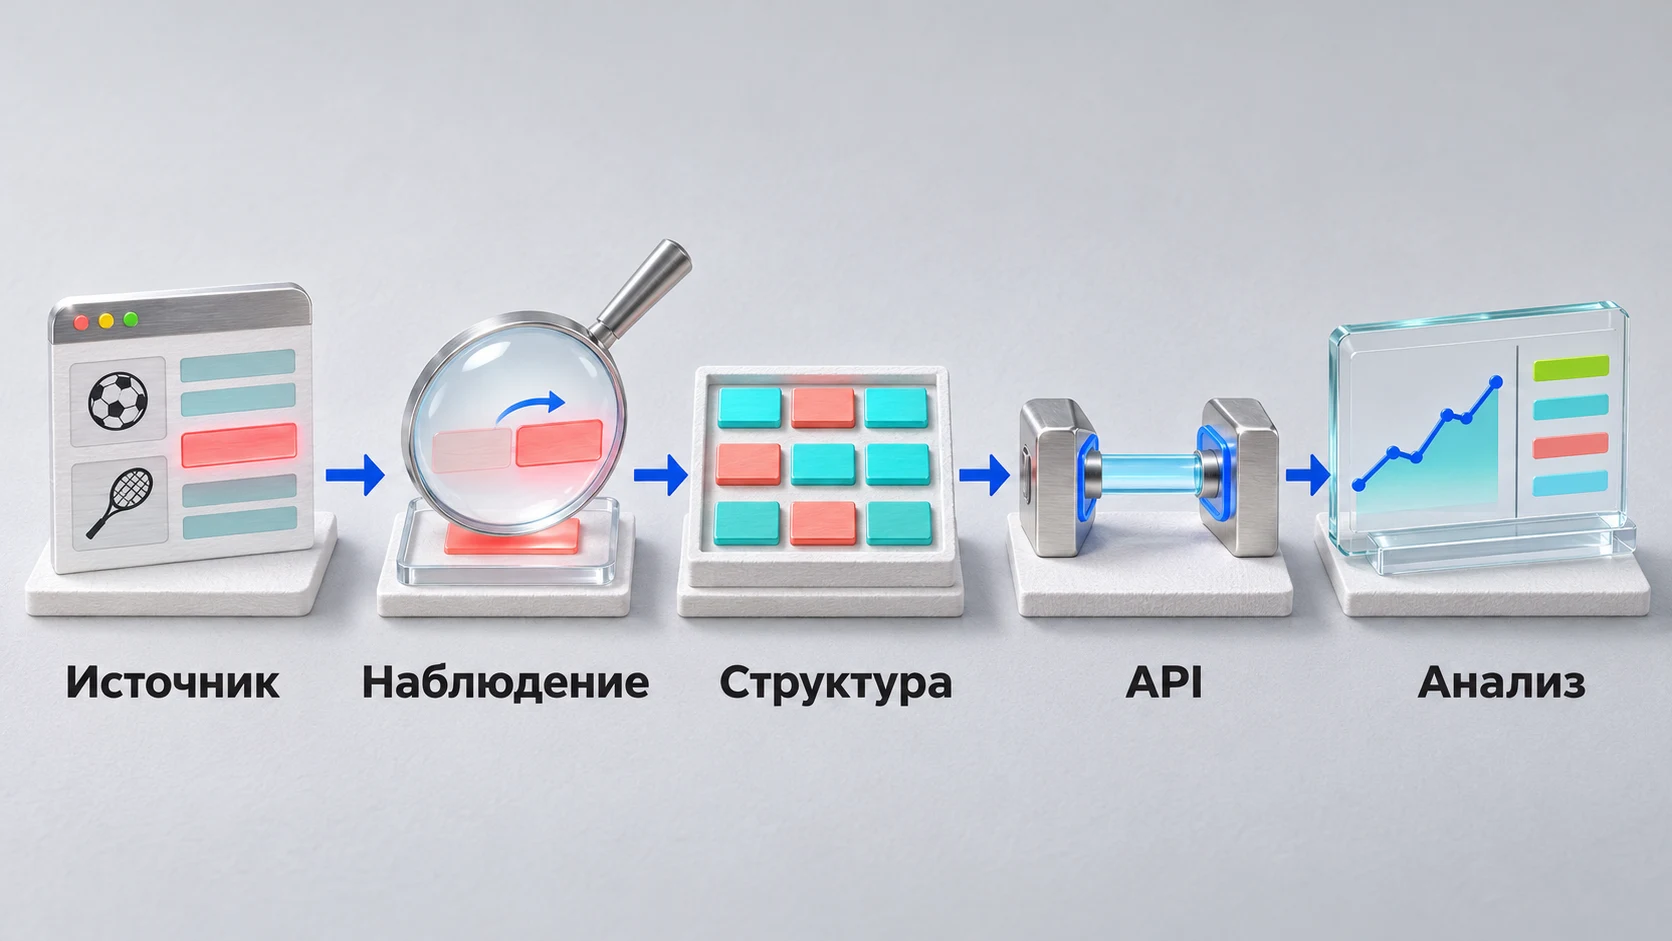
Мы подключили WowCash Crawler и организовали сбор, при котором система наблюдает за изменениями открытой страницы, разбирает их и передаёт дальше. В этом проекте от появления нового значения на странице до передачи клиенту проходит порядка 1–2 секунд. Ниже рассказываем, за счёт чего работает такая схема и почему одной быстрой загрузки сайта для неё недостаточно.
Задача: сохранить различия, а не получить среднее
У одного спортивного события может быть несколько представлений: разные названия, наборы исходов и коэффициенты на разных площадках. Клиенту были нужны именно эти различия. Усреднить значения означало бы потерять часть информации ещё до начала анализа.
Поэтому мы сохраняли данные каждого источника отдельно. Структурирование приводило их к виду, пригодному для автоматической обработки, но не подменяло исходные значения общим показателем. Сравнивать, делать выводы и выбирать дальнейшие сценарии должен был заказчик на своей стороне.
- Охват: более 30 букмекерских площадок, российских и зарубежных.
- Содержание: коэффициенты, результаты и другие согласованные данные по видам спорта, представленным у подключённых источников.
- Обновление: наблюдение за изменениями вместо одной периодической выгрузки.
- Получение: отправка в API клиента и возможность самостоятельно запрашивать данные через наш API.
Это частный кейс применения платформы. О её других задачах мы подробнее рассказали в статье «WowCash Crawler: сбор данных для ИИ и аналитики».
Почему парсинг букмекерских сайтов сложнее загрузки HTML
Исходный HTML страницы не всегда содержит то, что человек видит в браузере. Интерфейс может получать данные после загрузки, обновлять их через JavaScript и размещать часть элементов внутри Shadow DOM. Это отдельное дерево элементов веб-компонента: обычный поиск по документу не проходит через его границу автоматически.
Для сбора это существенная разница. Запрос завершился успешно, сервер вернул страницу, а нужных коэффициентов в полученном документе нет. Или они были при открытии, но затем поменялись без перезагрузки. Повторять прежний разбор недостаточно: нужно учитывать, как именно устроен источник и где появляются обновления.
WowCash Crawler работает с динамическим содержимым и элементами Shadow DOM. Но одинакового рецепта для всех сайтов нет: при подключении мы проверяем, как устроены компоненты и где появляются нужные значения.
Есть и другая граница: WAF и антибот-механизмы могут ограничивать автоматизированный доступ. Успешно открыть страницу один раз ещё не значит наладить постоянную поставку. Система должна замечать, когда рабочий интерфейс сменился проверкой доступа, когда оборвалась связь и когда разбор перестал находить нужные значения.
«Режим призрака»: остаёмся на странице и следим за изменениями
Так мы называем режим, в котором краулер держит активную сессию и наблюдает за обновлениями. Страница уже открыта. Когда источник меняет коэффициент или результат, система фиксирует изменение, превращает его в структурированные данные и передаёт клиенту.
Ради каждого нового значения не требуется заново загружать всю страницу. Клиенту, в свою очередь, не нужно каждый раз получать полный набор и искать в нём единственное изменившееся поле. В поток уходят изменения.
Нам было важно сократить путь от нового значения на странице до данных, с которыми уже может работать система клиента.
Простой пример: на одной площадке обновился коэффициент по конкретному исходу. В систему заказчика должно попасть новое значение именно этого источника. Остальные площадки могут обновиться позже или вообще сохранить прежние значения. Сбор не должен стирать эту разницу.
Такой подход особенно полезен во время матча, когда ждать очередной выгрузки неудобно. Но наблюдение за страницей не отменяет контроль сессии: если она перестала получать данные, отсутствие обновлений нельзя автоматически принимать за отсутствие изменений.
Что на самом деле означают 1–2 секунды
В этом кейсе речь идёт о задержке нашей цепочки: новое значение появилось на странице источника, краулер его получил, разобрал и передал клиенту. Порядка 1–2 секунд относятся к этому промежутку.
До него есть ещё один этап: спортивное событие произошло, а площадка опубликовала обновление. Скорость этого этапа зависит от источника. После передачи начинается обработка в системе заказчика, и она тоже занимает время. Складывать всё в обещание «данные со стадиона за секунду» было бы неправильно.
- Событие и публикация источником. На этот интервал наш краулер не влияет.
- Изменение на странице и передача клиенту. Именно здесь в проекте получаем порядка 1–2 секунд.
- Анализ и использование. Выполняются уже системой заказчика.
Это характеристика описанного проекта, а не гарантия такой же задержки для любого сайта и любой нагрузки. Доступность источника, его устройство и объём обновлений имеют значение. В новом проекте эти условия нужно разбирать до обещаний о скорости.
Разные регионы и проверки доступа
У краулера есть точки выхода в интернет в разных странах. Они позволяют работать с тем представлением площадки, которое доступно из выбранного региона. Для сравнения источников это важно: полученные сведения должны соответствовать согласованному контексту доступа.
В системе также используются собственные обученные нейросетевые модели для поддерживаемых типов CAPTCHA, включая изображения и задания с перемещением ползунка. Это часть работы с источниками, а не обещание автоматически проходить любую существующую проверку. Изменение защиты или интерфейса может потребовать доработки подключения.
Техническую возможность сбора мы отделяем от условий использования данных. До подключения необходимо определить допустимый режим доступа и права на дальнейшее использование информации. Региональная точка выхода или работа с проверками сами по себе такого разрешения не дают.
Страница открывается. А данные всё ещё правильные?
Самая неприятная ошибка сбора не обязательно выглядит как сбой. Страница может отвечать, соединение может работать, а результат разбора уже не соответствовать содержимому. Например, после перестановки элементов старый алгоритм перестал находить значение. Для принимающей системы это легко спутать с отсутствием данных у самого источника.
Поэтому в проекте контролируется вся цепочка: сетевые сбои, ошибки разбора и нарушения при структурировании. В контроле участвует ИИ. Его наличие не отменяет проверки результата: клиентский ИИ дальше работает именно с тем, что получил на вход.
Здесь полезно разделять три вопроса:
- Есть ли доступ? Открылась нужная страница или вместо неё показана ошибка либо проверка?
- Работает ли извлечение? Находятся ли нужные значения после обновления интерфейса?
- Сохранился ли смысл? Относится ли значение к правильному источнику, событию и исходу?
Последний вопрос особенно важен. Корректное число в неверном поле не становится полезными данными. Быстро передать его недостаточно: сначала нужно правильно понять, что именно изменилось.
Два способа получать данные через API
В этом проекте мы одновременно подключили два варианта доставки. Они нужны для разных сценариев и не мешают друг другу.
Краулер отправляет обновления в систему клиента
Новые данные поступают непосредственно в API заказчика по мере получения. Принимающая система может сразу запускать обработку. Ей не нужно постоянно спрашивать, появились ли изменения.
Клиент сам обращается к нашему API
Заказчик также может запросить нужные данные самостоятельно, в момент, который определяет его приложение. Это сохраняет свободу дальнейшей интеграции: входящий поток обновлений не становится единственным способом работы с информацией.
В другом проекте набор методов, формат, частота и поведение при недоступности получателя могут быть иными. Их стоит согласовать заранее. Эти вопросы относятся к поставке данных через API не меньше, чем сам формат ответа.
Как изменился процесс у заказчика
После запуска клиент перенёс обработку поступающей информации на собственную ИИ-систему и отказался от прежней команды аналитиков. Ему больше не требовалось строить этот этап вокруг ручной работы с разрозненными источниками: структурированные обновления поступали в автоматическую обработку.
Важно точно разделить роли. Мы не заменяли аналитиков универсальной моделью WowCash. Crawler обеспечил сбор, структурирование и передачу. Анализ, подготовка материалов и другие сценарии выполнялись средствами заказчика.
В этом проекте сошлись две части: постоянный поток данных и система клиента, готовая его обрабатывать. Одна без другой не дала бы такого результата.
Похожая зависимость есть и у обучения моделей. До выбора архитектуры нужно разобраться с составом, качеством и назначением данных. Об этом подробнее написали в материале о датасетах и нейросетях под задачи бизнеса.
С чего начинать похожий проект
Список сайтов нужен, но его мало. Важнее понять, какие решения будут приниматься по собранной информации. Одному приложению достаточно периодического среза. Другому необходимо получить изменение сразу, сохранить различия между источниками и передать его дальше без ручного вмешательства.
Для первого обсуждения мы предлагаем определить пять вещей:
- Источники и доступ. Какие площадки нужны, в каком региональном представлении и на каких условиях с ними можно работать.
- Состав данных. Какие события и поля требуются, что нельзя объединять или терять при структурировании.
- Требования к свежести. От какого момента считается задержка и насколько устаревшие данные ещё пригодны.
- Интеграцию. Куда отправлять обновления и какие запросы должно поддерживать API.
- Контроль. Как отличать отсутствие изменений от сбоя и какие ошибки требуют вмешательства.
В букмекерском кейсе ответом стал непрерывный поток из более чем 30 источников, с отдельными значениями каждой площадки и двумя способами получения. В другой отрасли устройство будет отличаться. Общая задача остаётся: превратить изменяющуюся страницу в данные, которым можно доверить следующий этап работы.
Если вы строите аналитику, редакционный инструмент или продукт с ИИ, обсудим сбор и структурирование данных под вашу задачу. Начнём с источников, нужных полей и способа доставки, затем определим подходящую схему.